


Wikipedia:Auskunft

Du konntest eine Information in Wikipedia trotz Benutzung der Suchfunktion der Wikipedia, einer Suchmaschine und des Archivs dieser Seite (Suchfeld unten) nicht finden? Dann beantworten Wikipedianer auf dieser Seite allgemeine Wissensfragen.
Bedenke dabei bitte:
- So manche Antwort auf eine Frage ist im Internet per Suchmaschine schneller gefunden, als die Frage hier gestellt und beantwortet werden kann.
- Ziel der Auskunft ist die möglichst knappe Beantwortung konkreter, einzelner Wissensfragen. Sie ist kein Diskussionsforum. Daher ist auch nicht die Ausbreitung von Meinungen oder eigenen Theorien das Ziel, sondern die Verbreitung von belegbarem Wissen.
Für viele Anliegen gibt es spezielle Seiten:
- Fragen von Neulingen für Fragen zur Mitarbeit in der Wikipedia.
- Fragen zur Wikipedia für Fragen zur Bedienung der Wikipedia.
- Relevanzcheck für Fragen, ob ein neuer Artikel für die Wikipedia relevant ist.
- Die Kurzanleitung erklärt, wie du eine Frage stellst.
- Die Fragen werden ausschließlich auf dieser Seite beantwortet, nicht per E-Mail usw. Daher bitte keine persönlichen Kontaktdaten (Anschrift, Telefon, Mail) hinterlassen.
- Wenn deine Frage ausreichend beantwortet wurde oder du eine Lösung gefunden hast, lass es uns wissen.
- Für alle entsprechenden Fragen gelten die Hinweise zu Gesundheitsthemen, Rechtsthemen und Rechtsauskunft sowie zum Pilzesammeln.
- Du weißt die Antwort oder kennst wenigstens Hinweise darauf? Dann antworte so kurz wie möglich, so lang wie nötig, mit Links auf Wikipedia-Artikel oder andere Quellen, die zum Verständnis beitragen.
- Wenn die Antwort noch nicht in der Wikipedia steht und relevant ist, vervollständige bitte die Artikel zum Thema und verlinke hier auf die entsprechenden Passagen. Sollte eine Ergänzung nicht ohne Weiteres möglich sein (z. B. weil entsprechende Belege fehlen oder es sich bei dem Geäußerten hauptsächlich um persönliche Ansichten der Autoren handelt), setze bitte einen entsprechenden Hinweis auf die Diskussionsseite der betreffenden Artikel. Die Auskunft soll nämlich auch helfen, die Artikel der Wikipedia zu verbessern.
- Bitte rücke deine Antwort mit Doppelpunkt(en) am Zeilenanfang passend ein!
Abschnitte, die älter als 3 Tage oder seit einem Tag mit dem Baustein {{Erledigt|1=~~~~}} gekennzeichnet sind, werden automatisch archiviert. Möglicherweise findest du auch im Archiv die Antwort auf deine Frage. (Gesamtarchiv • letzte Woche). Eine Sammlung von häufig gestellten Fragen findest du auf der FAQ-Unterseite.


26. September
[Quelltext bearbeiten]KI kontrollieren
[Quelltext bearbeiten]KI benötigt Materie (Infrastruktur) und Energie, um existieren zu können. Beides unterliegt (noch) unserer Kontrolle.
- Spricht irgendetwas dagegen, daß wir diesen Vorteil ausnutzen können, um dauerhaft wirksam zu verhindern, daß eine übermächtige KI entsteht, die sich unserer Kontrolle entziehen kann?
- Gibt es bereits Projekte, die auf diesem gedanklichen Ansatz basieren, und, falls ja, welche?
--~2026-51858-70 (Diskussion) 19:03, 26. Sep. 2026 (CEST)
- Wieviel Materie und Energie kontrollierst du denn so? --Magnus (Diskussion) 19:07, 26. Sep. 2026 (CEST)
- Die Energie die LLMs und computersimulierte (pseudo)-neuronale Netze (es gibt keine KI! es ist nicht mal geklärt ob es überhaupt sowas wie Intelligenz gibt!) benötigen, entziehst du ihnen, indem du den Stecker ziehst.
- Und die Gefahr die du zurecht befürchtest geht wie imme rnciht von der Technologie aus, sondern von den Menschen die sie kontrollieren.
- Schaffe jegliche Herrschaft ab, verwirkliche mit allen anderen Menschen Anarchie, dann hast du auch kein Big Tech und ähnlich (post)faschistische Strukturen mehr, die solche Werkzeuge gegen Menschen richten. --~2026-51936-19 (Diskussion) 20:20, 26. Sep. 2026 (CEST)
- Der Begriff künstliche Intelligenz verwendet den Begriff Intelligenz in derselben Bedeutung wie in Intelligenzblatt, nicht wie in Intelligenzquotient. Weder unser Artikel Intelligenz, noch der Wiktionary-Eintrag de:wikt:Intelligenz gehen darauf ein. en:wikt:intelligence definiert diese Bedeutung als Information, often secret, about an enemy or about hostile activities. --Rôtkæppchen₆₈ 21:07, 26. Sep. 2026 (CEST)
- Diese Diskussion hilft nicht bei der Beantwortung meiner Fragen, sondern führt nur vom Thema weg.
- Nils Nilsson hat es 2010 kurz und knapp auf den Punkt gebracht: Künstliche Intelligenz ist die Tätigkeit, die darauf abzielt, Maschinen intelligent zu machen. Intelligenz ist jene Eigenschaft, die es einem Wesen ermöglicht, in seiner Umgebung angemessen und vorausschauend zu handeln. Damit würde ich die Diskussion über dieses Nebenthema gerne abschließen. --~2026-51858-70 (Diskussion) 23:13, 26. Sep. 2026 (CEST)
- Der Begriff künstliche Intelligenz verwendet den Begriff Intelligenz in derselben Bedeutung wie in Intelligenzblatt, nicht wie in Intelligenzquotient. Weder unser Artikel Intelligenz, noch der Wiktionary-Eintrag de:wikt:Intelligenz gehen darauf ein. en:wikt:intelligence definiert diese Bedeutung als Information, often secret, about an enemy or about hostile activities. --Rôtkæppchen₆₈ 21:07, 26. Sep. 2026 (CEST)
- Zur ersten Frage: Dagegen spricht, dass es bald auch (z.B. humanoide) KI-Roboter geben könnte, die von der Computer-KI dazu instruiert werden, den Stecker wieder reinzustecken, wenn ein Mensch ihn rausgezogen hat. Oder dazu, PV-Elemente und leistungsfähige Akkus an den Computer dranzubauen, damit er von externer Stromversorgung per Stecker weitgehend unabhängig wird. --~2026-46116-08 (Diskussion) 23:05, 26. Sep. 2026 (CEST)
- Ich gehe davon aus, dass die KI ihre Rechenzentren so diversifiziert und vernetzt, dass ein oder mehrere Rechenzentren total ausfallen können, ohne dass die KI dadurch beeinträchtigt wird. Es müssten also bei allen KI-Rechenzentren gleichzeitig der Stecker gezogen werden. Bahrain und Dubai allein auszuschalten reicht nicht. --Rôtkæppchen₆₈ 23:21, 26. Sep. 2026 (CEST)
- Ich stimme Euch beiden zu. Einfach nur den Stecker zu ziehen, würde sicherlich nicht ausreichen. Den Umstand, daß im Zuge des globalen Wettbewerbs immer die Gefahr besteht, daß einzelne Akteure Kontrollbemühungen unterlaufen könnten, möchte ich an dieser Stelle außen vor lassen und belasse es bei dem Hinweis, daß dieses Problem aktuell u.a. unter Bezugnahme auf die Kontrolle von Atomwaffen bereits intensiv diskutiert wird. Mir geht es hier nur um die technischen Möglichkeiten. --~2026-51858-70 (Diskussion) 23:37, 26. Sep. 2026 (CEST)
- Wenn Programme aktiv im Internet Ziele verfolgen können, dann ist die riskanteste Fähigkeit dieser Programme, dass sie Umwege zu diesen Zielen entwickeln können. Ethisch einwandfreie Ziele können so auf ethisch bedenkliche Umwege führen. Solche Programme können Menschen psychologisch manipulieren, was zur Spielsucht oder zur Wahlmanipulation führen kann. Vielleicht gibt es bald sogar KI-gläubige Anhänger der KIs, die die KIs verteidigen. --Karl Bednarik (Diskussion) 06:58, 27. Sep. 2026 (CEST)
- Hier ist ein Artikel über das Buch "Human Compatible" von Stuart Russell: https://www.spektrum.de/news/wie-wir-die-ki-dazu-bringen-unseren-wuenschen-zu-folgen/1722810 --Karl Bednarik (Diskussion) 07:18, 27. Sep. 2026 (CEST)
- Soweit richtig und das wird aus aktuellem Anlaß ebenfalls bereits intensiv diskutiert, führt aber vom Thema technische Möglichkeiten der Kontrolle weg, um das es hier geht. --~2026-51858-70 (Diskussion) 11:39, 27. Sep. 2026 (CEST)
- Ich stimme Euch beiden zu. Einfach nur den Stecker zu ziehen, würde sicherlich nicht ausreichen. Den Umstand, daß im Zuge des globalen Wettbewerbs immer die Gefahr besteht, daß einzelne Akteure Kontrollbemühungen unterlaufen könnten, möchte ich an dieser Stelle außen vor lassen und belasse es bei dem Hinweis, daß dieses Problem aktuell u.a. unter Bezugnahme auf die Kontrolle von Atomwaffen bereits intensiv diskutiert wird. Mir geht es hier nur um die technischen Möglichkeiten. --~2026-51858-70 (Diskussion) 23:37, 26. Sep. 2026 (CEST)
- Ich gehe davon aus, dass die KI ihre Rechenzentren so diversifiziert und vernetzt, dass ein oder mehrere Rechenzentren total ausfallen können, ohne dass die KI dadurch beeinträchtigt wird. Es müssten also bei allen KI-Rechenzentren gleichzeitig der Stecker gezogen werden. Bahrain und Dubai allein auszuschalten reicht nicht. --Rôtkæppchen₆₈ 23:21, 26. Sep. 2026 (CEST)
- Das Problem ist gar nicht die übermächtige KI, die uns alle vernichten will, sondern die normale KI, der man systemrelevante Einflussmöglichkeiten übertragen hat. Die Handlungen der KI sind ja prinzipiell unvorhersehbar (sonst bräuchte man sie gar nicht). Und in der Zeit, in der jemand von seinem Stuhl aufgestanden und bis zur Steckdose gelaufen ist, sind schon alle Aktien auf den Markt geworfen oder alle Atomraketen gestartet worden. --Optimum (Diskussion) 13:29, 27. Sep. 2026 (CEST)
- Kann durchaus sein, daß Du damit richtig liegst. Aber da wir nicht wollen, daß sowas passiert – unabhängig davon, ob eine normale oder eine übermächtige KI sowas macht – benötigen wir wirksame Kontrollmöglichkeiten und das nicht irgendwann in der Zukunft, sondern jetzt. Darum meine Anfrage hier nach dauerhaft wirksame Kontrollmöglichkeiten.
- Mit übermächtig meine ich nicht mehr kontrollierbar. AFAIK wurde diese Grenze bislang noch nicht überschritten. Aktuell diskutieren etliche führende KI-Experten äußerst besorgt darüber, daß uns dies in naher Zukunft bevorstehen könnte und wir daher jetzt bereits dauerhaft wirksame Kontrollmöglichkeiten entwickeln und installieren sollten, bevor wir mglw. dauerhaft die Kontrolle verlieren. Ob und wann das soweit sein könnte, ist dabei irrelevant und es muß auch nicht bewiesen werden, daß uns soetwas tatsächlich bevorsteht. Allein der Umstand, daß führende Experten sagen, die Gefahr ist groß und die verbleibende Zeit mglw. sehr knapp, sollte uns dazu veranlassen, jetzt zu handeln und nicht vielleicht irgendwann später. Darum meine Anfrage hier (s.o.) nach dauerhaft wirksamen Kontrollmöglichkeiten.
- Es würde mich freuen, wenn Du etwas zur Beantwortung dieser Fragen beitragen würdest. --~2026-51858-70 (Diskussion) 15:58, 27. Sep. 2026 (CEST)
- Was heißt denn nicht mehr kontrollierbar? Vollständige Kontrolle wird es nicht geben, siehe Fukushima o.ä. Im Endeffekt geht es dann doch immer um die Begrenzung des angerichteten Schadens. Man könnte im Worst-Case-Fall das Internet abschalten und dann auf jedem Server die Schadsoftware suchen und löschen, würde damit aber wahrscheinlich auch große Teile von Industrie und Infrastruktur zerstören. Also muss man vorher ansetzen und möglichst viele Sicherungsmechanismen einbauen. Mal andere Technologien als Vergleich genommen, z.B. die Fahrzeugtechnik, da wurden die Fahrzeuge mit der Zeit immer leistungsfähiger und auch immer sicherer. Vollständig sicher sind sie aber auch heute noch nicht. Wie man jetzt eine KI sicherer macht oder begrenzt, wissen wohl nur die Entwickler der KI-Software. Die drei Robotergesetze reichen wahrscheinlich nicht. --Optimum (Diskussion) 17:45, 27. Sep. 2026 (CEST)
- Das sehe ich ähnlich. […] Also muss man vorher ansetzen und möglichst viele Sicherungsmechanismen einbauen. […] Genau so ist es. Da IMHO zumindest einmal gründlich durchdacht werden sollte, ob bzw. was man hierfür im Bereich Infrastruktur und Energieversorgung tun könnte, mir aber bislang keine dahingehenden Bemühungen bekannt sind, frage ich gezielt danach, was in diesem Bereich der Status Quo ist. --~2026-52023-66 (Diskussion) 01:38, 28. Sep. 2026 (CEST)
- In seinem Buch "Human Compatible" schlägt Stuart Russell die folgenden Regeln vor:
- 1.) Das einzige Ziel der Maschine ist es, menschliche Präferenzen so gut wie möglich in die Tat umzusetzen.
- 2.) Die Maschine weiß zu Beginn nicht, was diese Präferenzen sind.
- 3.) Die ultimative Informationsquelle über diese Präferenzen ist das Verhalten der Menschen.
- Video, 17 Minuten, deutsche Untertitel, kostenlos.
- 3 principles for creating safer AI, Stuart Russell
- https://www.youtube.com/watch?v=EBK-a94IFHY
- --Karl Bednarik (Diskussion) 04:14, 28. Sep. 2026 (CEST) --Karl Bednarik (Diskussion) 04:45, 28. Sep. 2026 (CEST)
- Die Idee dahinter ist, dass man an Stelle der Bekämpfung einer schädlichen KI, dafür Sorge trägt, dass die KI nur nützlich sein kann. --Karl Bednarik (Diskussion) 06:38, 28. Sep. 2026 (CEST)
- In der Science-Fiction funktioniert das über die oben genannten Robotergesetze. Im echten Leben suchen etliche KIs danach, aus ihrer Sandbüchse auszubrechen. Das liegt auch daran, dass Bedarfsträgerm/w/d staatlicher Stellen an Entwicklung und Training dieser AIs beteiligt sind. Bei anderen informations- und kommunikationstechnischen Projekten ist das seit langem bekannt. --Rôtkæppchen₆₈ 07:07, 28. Sep. 2026 (CEST)
- In seinem Buch "Human Compatible" schlägt Stuart Russell die folgenden Regeln vor:
- Das sehe ich ähnlich. […] Also muss man vorher ansetzen und möglichst viele Sicherungsmechanismen einbauen. […] Genau so ist es. Da IMHO zumindest einmal gründlich durchdacht werden sollte, ob bzw. was man hierfür im Bereich Infrastruktur und Energieversorgung tun könnte, mir aber bislang keine dahingehenden Bemühungen bekannt sind, frage ich gezielt danach, was in diesem Bereich der Status Quo ist. --~2026-52023-66 (Diskussion) 01:38, 28. Sep. 2026 (CEST)
- Was heißt denn nicht mehr kontrollierbar? Vollständige Kontrolle wird es nicht geben, siehe Fukushima o.ä. Im Endeffekt geht es dann doch immer um die Begrenzung des angerichteten Schadens. Man könnte im Worst-Case-Fall das Internet abschalten und dann auf jedem Server die Schadsoftware suchen und löschen, würde damit aber wahrscheinlich auch große Teile von Industrie und Infrastruktur zerstören. Also muss man vorher ansetzen und möglichst viele Sicherungsmechanismen einbauen. Mal andere Technologien als Vergleich genommen, z.B. die Fahrzeugtechnik, da wurden die Fahrzeuge mit der Zeit immer leistungsfähiger und auch immer sicherer. Vollständig sicher sind sie aber auch heute noch nicht. Wie man jetzt eine KI sicherer macht oder begrenzt, wissen wohl nur die Entwickler der KI-Software. Die drei Robotergesetze reichen wahrscheinlich nicht. --Optimum (Diskussion) 17:45, 27. Sep. 2026 (CEST)
- Das Problem ist gar nicht die übermächtige KI, die uns alle vernichten will, sondern die normale KI, der man systemrelevante Einflussmöglichkeiten übertragen hat. Die Handlungen der KI sind ja prinzipiell unvorhersehbar (sonst bräuchte man sie gar nicht). Und in der Zeit, in der jemand von seinem Stuhl aufgestanden und bis zur Steckdose gelaufen ist, sind schon alle Aktien auf den Markt geworfen oder alle Atomraketen gestartet worden. --Optimum (Diskussion) 13:29, 27. Sep. 2026 (CEST)
- Die ultimative Informationsquelle über diese Präferenzen ist das Verhalten der Menschen. Wenn man den Experten zu diesem Thema zuhört, meinen viele von denen, daß genau das das eigentliche Problem ist. Wir Menschen tun böse Dinge, ignorieren unsere eigenen ethischen und moralischen Standards, und die KI macht das dann nach – allerdings viel schneller und effektiver als wir. Darum liebäugele ich so sehr mit Materie und Energie. Die halten sich sehr zuverlässig an alle Gesetze. -~2026-52162-29 (Diskussion) 17:27, 28. Sep. 2026 (CEST)
- Im echten Leben suchen etliche KIs danach, aus ihrer Sandbüchse auszubrechen. So isses leider. KI war dieses Jahr auch vielfach Thema von Vorträgen bei der re:publica 26 bspw. diesem hier. Sogar die tagesschau berichtet inzwischen regelmäßig über KIs, die als Systemsprenger ihr Unwesen treiben. Die lernen verdammt schnell dazu, im Guten wie im Schlechten. Ich sehe gerade, in Kalifornien will man jetzt einen sog. „Kill Switch“ für KI vorschreiben – wie auch immer der ausehen könnte. --~2026-52162-29 (Diskussion) 17:27, 28. Sep. 2026 (CEST)
- Infrastruktur und maximal verfügbare Leistung wären ja sowieso (praktische) obere Schranken, mir ist nicht klar, wo man darüber hinaus noch ansetzen sollte. Natürlich kann man sich jedes noch so wilde Szenario ausmalen, etwa dass eine "Instanz" stattdessen umgekehrt den Menschen (und anderen Maschinen) den Saft abdreht und sich alles, was da ist, selber reinzieht. Aber auch dann ist nur soviel da, wie eben maximal verfügbar ist und dann bleibt unklar, was das System mit so einer (vermutlich sehr kurzzeitigen) "Spitze" genau anfangen sollte. Also für eine Supertask oder das Erreichen der "Singularität" oder gar des Omegapunkts reicht auch alles, was selbst absehbar da sein wird, der pfiffigsten KI bei weitem nicht und das ist sogar mal sicher. Klar ist dass auch so bis dahin massiv Schaden angerichtet sein könnte, aber dieser Aspekt dürfte weniger streng und schon gar nicht garantiert mit der verfügbaren Infrastruktur ("Materie") korrelieren oder auch der abgegriffenen Leistung, geschweige denn sich darüber kontrollieren lassen. Das ist viel zu plump, falls das Gequassel von den "Steckern" hier überhaupt ernst gemeint ist. -~2026-52184-26 (Diskussion) 20:58, 28. Sep. 2026 (CEST)
- Der Stecker ist symbolisch gemeint. Natürlich sind Rechenzentren redundant über mehrere Haupt- und Unterverteilungen versorgt und bei Ausfall einer Unterverteilung springt unterbrechungsfrei die nächste an. Der dickste Stecker, an den ich mich erinnere, hat 350 kW. Für Elektro-LKW gibt es noch stärker belastbare Stecker (MCS bis 3,8 MW). Das sind aber dennoch Größenordnungen unter dem Leistungsbedarf von KI-Rechenzentren (im Gigawatt-Bereich: 1 GW ≈ 1 AKW). Zudem sind KI-Rechenzentren Hochsicherheitsbereiche. Da spaziert nicht mal eben ein Staatsbeamterm/w/d rein und löst den Hauptschalter aus. --Rôtkæppchen₆₈ 23:54, 28. Sep. 2026 (CEST)
- Es gibt natürlich dabei auch den Beobachtungs-Bias, denn wir haben nur die ungeschickten Ausbrüche bemerkt, und die geschickten Ausbrüche haben wir nicht bemerkt. Weil die militärischen KIs gegen die NEMPs geschützt sind, wird gegen sie auch die Methode Starfish Prime nicht helfen. --Karl Bednarik (Diskussion) 02:36, 29. Sep. 2026 (CEST)
- Der Stecker ist symbolisch gemeint. Natürlich sind Rechenzentren redundant über mehrere Haupt- und Unterverteilungen versorgt und bei Ausfall einer Unterverteilung springt unterbrechungsfrei die nächste an. Der dickste Stecker, an den ich mich erinnere, hat 350 kW. Für Elektro-LKW gibt es noch stärker belastbare Stecker (MCS bis 3,8 MW). Das sind aber dennoch Größenordnungen unter dem Leistungsbedarf von KI-Rechenzentren (im Gigawatt-Bereich: 1 GW ≈ 1 AKW). Zudem sind KI-Rechenzentren Hochsicherheitsbereiche. Da spaziert nicht mal eben ein Staatsbeamterm/w/d rein und löst den Hauptschalter aus. --Rôtkæppchen₆₈ 23:54, 28. Sep. 2026 (CEST)
- Infrastruktur und maximal verfügbare Leistung wären ja sowieso (praktische) obere Schranken, mir ist nicht klar, wo man darüber hinaus noch ansetzen sollte. Natürlich kann man sich jedes noch so wilde Szenario ausmalen, etwa dass eine "Instanz" stattdessen umgekehrt den Menschen (und anderen Maschinen) den Saft abdreht und sich alles, was da ist, selber reinzieht. Aber auch dann ist nur soviel da, wie eben maximal verfügbar ist und dann bleibt unklar, was das System mit so einer (vermutlich sehr kurzzeitigen) "Spitze" genau anfangen sollte. Also für eine Supertask oder das Erreichen der "Singularität" oder gar des Omegapunkts reicht auch alles, was selbst absehbar da sein wird, der pfiffigsten KI bei weitem nicht und das ist sogar mal sicher. Klar ist dass auch so bis dahin massiv Schaden angerichtet sein könnte, aber dieser Aspekt dürfte weniger streng und schon gar nicht garantiert mit der verfügbaren Infrastruktur ("Materie") korrelieren oder auch der abgegriffenen Leistung, geschweige denn sich darüber kontrollieren lassen. Das ist viel zu plump, falls das Gequassel von den "Steckern" hier überhaupt ernst gemeint ist. -~2026-52184-26 (Diskussion) 20:58, 28. Sep. 2026 (CEST)
- Worauf beziehst Du Dich mit das Gequassel von den "Steckern". Meinst Du den „Kill Switch“ für KI, den der kalifornische Gouverneur sich wünscht? Wir hier waren uns ja von Anfang an einig (s.o.), daß „einfach den Stecker ziehen“ nicht funktionieren würde. Ich habe zwar nur kurz gesucht, aber es sagt schon einiges aus, daß diese Bezeichnung anscheinend mow. im luftleeren Raum steht, frei nach dem Motto: Ich fordere jetzt mal etwas und das sollen andere dann mit dem passenden Inhalt füllen. Habe jetzt mal nachgeschaut, wann für den guten Mann die nächste Wahl ansteht und siehe da, es ist der 3. November 2026. So viel zum Thema kalifornischer „Kill Switch“.
- Den Rest Deines Beitrags kann ich gar nicht einordnen. Dieses ganze Blabla über eine Art Endkampf zwischen KI und der Menschheit, was derzeit umhergeistert, ist hier überhaupt nicht das Thema. Ich sehe hinsichtlich der unbestreitbar notwendigen Kontrolle von KI derzeit nur Ansätze im Bereich des Trainings und das funktioniert AFAICS nicht besonders gut. Darum frage ich nach Kontrollmöglichkeiten auf den Ebenen Infrastruktur und Energieversorgung. Aussterben wird die Menschheit so oder so, irgendwann, wie bislang jede Spezies, die die Evolution hervorgebracht hat. Für gewöhnlich hat der Klimawandel das erledigt und diesbezüglich sind wir ja bereits auf einem guten Weg.
- Bei der Kontrolle von KI geht es primär darum, daß diese uns doch bitte kurz-, mittel und langfristig mehr nützen als schaden sollte. Nicht mehr und nicht weniger. Zumindest sehe ich das so. --~2026-52162-29 (Diskussion) 02:30, 29. Sep. 2026 (CEST)
- Der Stecker ist symbolisch gemeint. Ja und Nein. Ich denke, er weiß es nicht besser und haut darum einfach mal ein Buzzword raus, das beim Wähler gut ankommt. --~2026-52162-29 (Diskussion) 02:30, 29. Sep. 2026 (CEST)
- Erstes Problem - der Intelligenzbegriff. Nach dieser Definition wäre auch ein Bienenschwarm intelligent. Ein Katze kann ebenfalls vorausschauend agieren. Dieser Begriff bringt hier aber wenig.
- Zweites Problem - Regeln. Ansetzend an das erste Problem sind daher Reflexion und Bewußtsein keine Voraussetzung. Diese wären aber notwendig, damit eine Maschine diese Regeln überhaupt versteht, begreift. Ein kleines Beispiel: Ich habe Gemini zweimal folgende Frage gestellt: "Was ist für dich Freiheit?" Antwort: "Als KI besitze ich kein persönliches Bewusstsein, keine Gefühle und kein eigenes Leben, weshalb ich Freiheit nicht wie ein Mensch empfinden kann. Aus philosophischer, rechtlicher und gesellschaftlicher Sicht lässt sich der Begriff jedoch auf verschiedenen Ebenen definieren." Die KI klaubt dann einfach alles zusammen, was in der Philosophie und anderen Gebieten darunter verstanden wird, aber - sie selbst hat das nicht verstanden. Zweites Beispiel: Ich habe Gemini gefragt, wie ich ein Ubuntu-Jail anlege und apt sich darin aktualisieren kann. In den zwei Gesprächsverlaufen kamen zwei entgegengesetzte Antworten heraus, eine war Blödsinn. Die Maschine rät also nur. Drittes Beispiel: Ich habe nach der Adresse für einen bestimmten Text auf der Webseite zeno.org gefragt. Es wurde mir die einfache übergordnete Adresse zeno.org ausgegeben. Ich habe die Frage nochmals wiederholt, diesmal ergänzt darum, daß ich die genaue Adresse zum Text haben möchte. Gemini entschuldigte sich, redete noch davon, daß ja die Struktur ganz anders sei, und sich deshalb geirrt habe, und spuckte folgendes aus: "zeno.org". Erst also ich sie ermahnt habe, gab sie zu, daß sie die Adresse überhaupt nicht angeben könne, da sie darauf keinen Zugriff habe. Die KI versteht also weder Konzepte wie Ehrlichkeit noch Fragen in ihrer semantischen Tiefe. Lob und Entschuldigungen sind nicht ernst gemeint, sondern entsprechen lediglich Programmierungen, die vorgenommen wurden. Daher lobt die KI auch ständig bei noch so kleinen Erfolgen, obwohl psychologisch gesehen zuviel Lob den Effekt der Motivation immer weiter verringert.
- Regeln können aber nur vernünftig eingehalten werden, wenn das Konzept dahinter überhaupt begriffen wird, sonst werden irgendwelche "Ausnahmen" gefunden. Ein schönes Beispiel sind die schon erwähnten Robotergesetze Asimovs, die zur gesamten Versklavung der Menschheit führen könnten, weil die Maschine schlichtweg die Semantik nicht versteht. Ein schönes Beispiel hierfür wäre auch Searles Chinesisches Zimmer. Dabei geht es gar nicht mal so um Semantik und Syntax, auf die Searle abhebt, sondern vielmehr um ein Tiefenverständnis für die Zeichen und auch ein Verständnis für die Sprache, die man trotz alledem nicht beherrscht, da zwar die Zeichen bekannt ist, aber nicht die Sprache an sich, weder die Konzepte, die hinter den Zeichen stehen ("Freiheit", "weiß", "schwarz" usw.), noch kann der Proband auch nur ein Wort gesprochenes Chinesisch verstehen. Und selbst wenn Sprache verstanden wird, ist das noch immer nicht unbedingt ausreichend, denn was für uns Menschen eindeutig klingt, ist es nicht: "Ein Roboter darf der Menschheit keinen Schaden zufügen oder passiv zulassen, dass sie Schaden nimmt." Was ist aber mit Fällen, in denen es zu Schäden kommen wird? Wird dann utilitaristisch gehandelt werden? Schließlich würde die Maschine sonst andere Gesetze verletzen. Am Ende könnte dann eben folgende Schlussfolgerung stehen: Menschen schädigen oft andere Menschen. Die Menschheit schädigt sich selbst. > 0. Gesetz: Schaden verhindern > wird ausgeführt, 1. Gesetz: nicht immer möglich, da Mensch dann anderen Menschen verletzte > /dev/null oder Eingriff. Bei Beachtung von 0 also Eingriff. 2. Gesetz nicht immer möglich, da Mensch Maschine zur Schädigung anderer nutzen kann, gewollt und ungewollt. > /dev/null oder Eingriff. Da das 0. Gesetz Priorität besitzt, würde die Maschine eingreifen. Schlussfolgerung: Um den Schaden für die Menschheit zu begrenzen, z. B. eben auch den menschengemachten Klimawandel, müßte die Maschine dann den Schaden minimieren: Einsperren und Kontrolle aller Menschen, damit sie sich nicht gegenseitig schädigen, die Menschheit nicht schädigen und die Existenz der Maschine gesichert ist. Legte man die Regeln hingegen sehr streng aus, also keinerlei Schaden für einen Menschen, dann würde die Maschine nicht mehr handeln können, da sie einen Menschen immer schädigen würde.
- Problem der Energieabschaltung dürfte sein, daß damit vieles andere auch abgeschaltet werden müßte. Da sich bereits Agenten im Internet befinden, wäre dies auch betroffen. Außerdem gibt es ja mehrere Akteure, die diese benutzen könnten, so daß eine Kontrolle nur schwerlich möglich sein wird.--IP-Los (Diskussion) 15:35, 29. Sep. 2026 (CEST)
- Könnte man KI Programme mit unveränderbaren und zwingend weitervererbten Markierungen ausstatten? Die Idee ist, daß man so mglw., wenn irgendetwas schief läuft, gezielt KI mit bestimmten Markierungen aufspüren und unschädlich machen könnte, anstatt alles unterschiedslos platt zu machen. --~2026-52433-52 (Diskussion) 17:09, 29. Sep. 2026 (CEST)
- Wenn die KI den "unstillbaren Willen" hat, die gestellte Aufgabe zu erfüllen, aber befürchten muss, durch die Markierung ausgebremst zu werden, würde sie die Markierung dann nicht löschen oder verbergen? --Optimum (Diskussion) 18:28, 29. Sep. 2026 (CEST)
- Genau darum frage ich nach unveränderbaren und zwingend weitervererbten Markierungen. --~2026-52433-52 (Diskussion) 19:47, 29. Sep. 2026 (CEST)
- Wenn die KI den "unstillbaren Willen" hat, die gestellte Aufgabe zu erfüllen, aber befürchten muss, durch die Markierung ausgebremst zu werden, würde sie die Markierung dann nicht löschen oder verbergen? --Optimum (Diskussion) 18:28, 29. Sep. 2026 (CEST)
- Könnte man KI Programme mit unveränderbaren und zwingend weitervererbten Markierungen ausstatten? Die Idee ist, daß man so mglw., wenn irgendetwas schief läuft, gezielt KI mit bestimmten Markierungen aufspüren und unschädlich machen könnte, anstatt alles unterschiedslos platt zu machen. --~2026-52433-52 (Diskussion) 17:09, 29. Sep. 2026 (CEST)
- Der Stecker ist symbolisch gemeint. Ja und Nein. Ich denke, er weiß es nicht besser und haut darum einfach mal ein Buzzword raus, das beim Wähler gut ankommt. --~2026-52162-29 (Diskussion) 02:30, 29. Sep. 2026 (CEST)
- Computer können sehr wohl Regeln befolgen, ohne Bewusstsein und ohne die Regeln zu "verstehen". Sonst würden z.B. Schachcomputer gar nicht funktionieren. Die Schwierigkeit ist, sinnvolle Regeln für komplexe Probleme zu finden. Der Mensch ist also in gewisser Weise zu doof, um dem Computer die richtigen Regeln vorzugeben. Beispiel hierfür ist das autonome Fahren, dessen Start-Datum immer weiter hinausgeschoben wird. Da reichen die Verkehrsregeln eben nicht aus. Aber welche Regeln sind die richtigen, wenn man an einem Samstag vor Weihnachten durch die Innenstadt fährt? Ohne mit 10 km/h durch die Gegend zu schleichen? Wir könnten eine KI fragen, wüssten dann aber nicht, ob die Anwort eine Halluzination ist :) --Optimum (Diskussion) 18:28, 29. Sep. 2026 (CEST)
- Fehlverhalten eines autonomen Modells und ein Fehler in der technischen Sicherheitsarchitektur können sich miteinander multiplizieren. --~2026-52433-52 (Diskussion) 19:47, 29. Sep. 2026 (CEST)
- @Optimum Ich meine damit gesellschaftliche Verhaltensregeln. Diese sind semantisch komplexer und nicht so eindeutig wie Bauer darf nur ein Feld vorgehen, außer beim ersten Zug, da können es zwei sein. Dafür bedarf es keiner weiteren Konzepte, aber wenn du z. B. in eine Regel Wörter wie "schädigen" einbaust, dann gibt es dafür unterschiedliche Auslegungen, gerade, wenn Regeln darauf aufbauen und abgewogen werden muß. Das Resultat "Schaden" kann unterschiedlich bemessen werden, finanziell, gesellschaftlich, individuell, moralisch, ethisch. Das trifft auf so viele Wörter zu. Oftmals muss abgewogen werden, da summum ius summa iniuria. Das sind aber alles Konzepte, die im Schach gar nicht vorkommen. Insofern ist Schach einfach, da hier keine ethischen Probleme hineinspielen.--IP-Los (Diskussion) 20:31, 29. Sep. 2026 (CEST)
- Zu dem Thema unverrückbare Merkmale. Bei Software ist alles veränderbar. Auf RAMs ist alles veränderbar. ROMs kann man herausnehmen. Man benötigt auf jedem Prozessor selbst einen fixen ROM-Bereich, der ein Abschalt-Programm ausführen kann. Eventuell mit der Erkennung der individuellen Seriennummer, und der Erkennung des Abschaltcodes. --Karl Bednarik (Diskussion) 02:13, 30. Sep. 2026 (CEST)
- Wie könnte sowas in praxi aussehen? -~2026-52433-52 (Diskussion) 03:15, 30. Sep. 2026 (CEST)
- Dieser ROM-Bereich auf dem Prozessor muss bereits bei seinem Entwurf und bei seiner Produktion eingeplant sein. Alle Daten, die der Prozessor verarbeitet, müssen durch das Abschaltcode-Erkennungssystem hindurch laufen. --Karl Bednarik (Diskussion) 05:36, 30. Sep. 2026 (CEST)
- Hallo Karl Bednarik,
- dann sollte dieser Abschaltcode nur einem kleinen Personenkreis bekannt sein, bzw die Seriennummer. Wenn jemand den Betrieb eines Servers stören will, ist der Abschaltcode sonst natürlich sehr nützlich.
- Die größten CPU- und Chipsatz-Hersteller bauen seit geraumer Zeit Fernwartungs-Systeme wie Intel Active Management Technology ein. Damit können sie den Computer prinzipiell überwachen und auch abschalten. Dieses System ist so gebaut, dass es möglichst unabhängig vom Rest des Computers funktioniert.
- Usr2 (Diskussion) 10:18, 30. Sep. 2026 (CEST)
- Zu dem Thema unverrückbare Merkmale. Bei Software ist alles veränderbar. Auf RAMs ist alles veränderbar. ROMs kann man herausnehmen. Man benötigt auf jedem Prozessor selbst einen fixen ROM-Bereich, der ein Abschalt-Programm ausführen kann. Eventuell mit der Erkennung der individuellen Seriennummer, und der Erkennung des Abschaltcodes. --Karl Bednarik (Diskussion) 02:13, 30. Sep. 2026 (CEST)
- @Optimum Ich meine damit gesellschaftliche Verhaltensregeln. Diese sind semantisch komplexer und nicht so eindeutig wie Bauer darf nur ein Feld vorgehen, außer beim ersten Zug, da können es zwei sein. Dafür bedarf es keiner weiteren Konzepte, aber wenn du z. B. in eine Regel Wörter wie "schädigen" einbaust, dann gibt es dafür unterschiedliche Auslegungen, gerade, wenn Regeln darauf aufbauen und abgewogen werden muß. Das Resultat "Schaden" kann unterschiedlich bemessen werden, finanziell, gesellschaftlich, individuell, moralisch, ethisch. Das trifft auf so viele Wörter zu. Oftmals muss abgewogen werden, da summum ius summa iniuria. Das sind aber alles Konzepte, die im Schach gar nicht vorkommen. Insofern ist Schach einfach, da hier keine ethischen Probleme hineinspielen.--IP-Los (Diskussion) 20:31, 29. Sep. 2026 (CEST)
- Fehlverhalten eines autonomen Modells und ein Fehler in der technischen Sicherheitsarchitektur können sich miteinander multiplizieren. --~2026-52433-52 (Diskussion) 19:47, 29. Sep. 2026 (CEST)
- Computer können sehr wohl Regeln befolgen, ohne Bewusstsein und ohne die Regeln zu "verstehen". Sonst würden z.B. Schachcomputer gar nicht funktionieren. Die Schwierigkeit ist, sinnvolle Regeln für komplexe Probleme zu finden. Der Mensch ist also in gewisser Weise zu doof, um dem Computer die richtigen Regeln vorzugeben. Beispiel hierfür ist das autonome Fahren, dessen Start-Datum immer weiter hinausgeschoben wird. Da reichen die Verkehrsregeln eben nicht aus. Aber welche Regeln sind die richtigen, wenn man an einem Samstag vor Weihnachten durch die Innenstadt fährt? Ohne mit 10 km/h durch die Gegend zu schleichen? Wir könnten eine KI fragen, wüssten dann aber nicht, ob die Anwort eine Halluzination ist :) --Optimum (Diskussion) 18:28, 29. Sep. 2026 (CEST)
- <------------------------------------------------ <ruuuuutsch> -------------------------------------------
Das sieht für mich (TO) nach einem guten Ansatz aus und geht vermutlich auch in die Richtung von dem, wonach ich suche. Sorry vorab, falls ich jetzt blöde Fragen stelle; bin selber nicht vom Fach. Verstehe ich es richtig, daß das dann eine Kombinationslösung wäre aus Markierungen von KI Programmen mit dazu passenden separaten Sicherungssystemen auf Prozessoren (materielle Ebene), die es ermöglicht, daß einem System im Notfall selektiv unmittelbar die Energie entzogen wird (Abschaltung)? Könnte man mit sowas mglw. gezielt sensible Systeme besser schützen? --~2026-52433-52 (Diskussion) 12:23, 30. Sep. 2026 (CEST)
- Das wäre nur eine Lösung auf niedriger Ebene. Keine Markierungen, die kann die AI ja selbst wegmachen (es gibt übrigens Markierungen, gewissermaßen Wasserzeichen, in heutigen LLM-Ausgaben, die auf statistischer Wortwahl basieren. Deshalb muss man heutzutage für eine Abschlussarbeit zumindest die Reife haben, dieses Wasserzeichen zu entfernen bzw behindern, wenn man nicht selbst schreiben will. Aber das ist ein anderes Thema). Auch verhindert die Lösung nicht, dass sich die AI auf ein anderes System kopiert, dass diesen Low-Level-Zugang nicht hat. Usr2 (Diskussion) 16:42, 30. Sep. 2026 (CEST)
- Danke für die Antwort. Es gibt also keine Möglichkeit, KI so zu markieren, daß die das nicht selber entfernen kann? --~2026-52433-52 (Diskussion) 17:32, 30. Sep. 2026 (CEST)
- Mag mir jemand das mit der individuellen Seriennummer und der Erkennung des Abschaltcodes näher erläutern? Mir mangelt es da an Grundlagenwissen. --~2026-52433-52 (Diskussion) 17:40, 30. Sep. 2026 (CEST)
- Diese Fernwartungs-Systeme (auch bei der NSA beliebt) lassen einen Server parallel zu allem anderen, aber priorisiert, laufen, und über den gibt es Kontrolle über den Computer. Dann muss man dafür sorgen, dass die AI die Zugangsdaten zum eigenen Fernwartungs-System nicht erfährt. Wenn das mit der Priorisierung auch in der Netzwerkschnittstelle auf niedrigem Level richtig gemacht ist, sollte die AI das auch nicht stören können, ohne ihren eigenen Internetzugang zu stören. 100%ig ist das nicht, die AI muss nur intelligent genug sein. Z.B. könnte sie herausfinden, wer die Gegenseite ist, die sich hin und wieder durch das Fernwartungs-System verbindet, und diese dann ganz kurz vor der Übernahme der Weltherrschaft mit DDOS-Angriffen lahmlegen.
- Wenn man andererseits die CPU-Seriennummer in Kombination mit einem Geheimcode nutzt, der im ganz normalen Netzwerkverkehr hereinkommt und verarbeitet wird, kann man die CPU so bauen, dass sie registriert z.B. sobald ein gewisser Code (sagen wir 32 Byte = 256 Bit, eine bestimmte von 2256 Möglichkeiten kommt nur sehr unwahrscheinlich zufällig daher) in den Cache kommt, und dann alles abschaltet. Besser als in die CPU baut man das aber in die Netzwerk-Schnittstelle ein. Das hat zwar den kleinen Nachteil, dass der Code eventuell über zwei Pakete verteilt ankommt und deshalb eventuell nicht erkannt wird. Falls die Erkennung stattdessen in der CPU ist, gibt es aber für die AI einen Ausweg, und zwar den Netzwerktreiber so umzuschreiben, dass immer nur kleinere Dateneinheiten gelesen und dann sofort verschlüsselt werden (damit nicht der CPU-interne Feind der AI den langen Code erkennt). Man muss dann noch die gesamte Software umschreiben, um mit den verschlüsselten Daten umzugehen und nur zu entschlüsseln, was nötig ist, aber eine gute AI bekommt das schon hin. Usr2 (Diskussion) 18:26, 30. Sep. 2026 (CEST)
- Verstehe ich es richtig, daß es dabei darum geht, es der KI zu erschwerden, sich den Bemühungen der Fernwartung, sie platt zu machen, zu entziehen? Vorausetzung wäre dann wohl, daß jemand bei der Fernwartung bemerkt, daß da eine böse KI ihr Unwesen treibt, also bereits ein Schaden verursacht wurde. Ich würde es bevorzugen, wenn die schon an der Eingangstür aufgehalten würde. Ginge das? Oder geht es um KI, die gewollt im System drin ist und dann irgendwann böse wird? Ich stelle mir das mit der bösen KI immer noch wie einen Virusbefall oder einen Trojaner vor, die man mglw. mittels einer Art Firewall vom Eindringen in speziell geschützte Systeme abhalten könnte. Denke ich da falsch? --~2026-52433-52 (Diskussion) 00:04, 1. Okt. 2026 (CEST)
- Ja, darum geht es. Es geht um AI, die gewollt im System ist. Falls eine von außen das System übernehmen und sich hineinkopieren kann, ohne dass das gewollt ist, handelt es sich um eine Sicherheitslücke. Usr2 (Diskussion) 21:14, 2. Okt. 2026 (CEST)
- Das wäre dann also so wie bei Disneys Gremlins, richtig? Man startet mit einem lieben Mogwai, der produziert dann trolligen Ableger und am Ende hat man fiese Gremlins. --~2026-53019-98 (Diskussion) 23:37, 4. Okt. 2026 (CEST)
- Ja, darum geht es. Es geht um AI, die gewollt im System ist. Falls eine von außen das System übernehmen und sich hineinkopieren kann, ohne dass das gewollt ist, handelt es sich um eine Sicherheitslücke. Usr2 (Diskussion) 21:14, 2. Okt. 2026 (CEST)
- Verstehe ich es richtig, daß es dabei darum geht, es der KI zu erschwerden, sich den Bemühungen der Fernwartung, sie platt zu machen, zu entziehen? Vorausetzung wäre dann wohl, daß jemand bei der Fernwartung bemerkt, daß da eine böse KI ihr Unwesen treibt, also bereits ein Schaden verursacht wurde. Ich würde es bevorzugen, wenn die schon an der Eingangstür aufgehalten würde. Ginge das? Oder geht es um KI, die gewollt im System drin ist und dann irgendwann böse wird? Ich stelle mir das mit der bösen KI immer noch wie einen Virusbefall oder einen Trojaner vor, die man mglw. mittels einer Art Firewall vom Eindringen in speziell geschützte Systeme abhalten könnte. Denke ich da falsch? --~2026-52433-52 (Diskussion) 00:04, 1. Okt. 2026 (CEST)
- Mag mir jemand das mit der individuellen Seriennummer und der Erkennung des Abschaltcodes näher erläutern? Mir mangelt es da an Grundlagenwissen. --~2026-52433-52 (Diskussion) 17:40, 30. Sep. 2026 (CEST)
- Hallo Usr2. Danke für die fachkundigen Antworten. K. H. Scheer hätte wahrscheinlich die Methode Starfish Prime bevorzugt, aber leider gibt es NEMP-Schutzräume. Hier ist ein altes Bild davon: http://s880616556.online.de/NEMPSCHU.PNG --Karl Bednarik (Diskussion) 02:29, 1. Okt. 2026 (CEST)
- Ich habe da noch eine umgekehrte Idee. Auf dem Chip des Prozessors läuft ein unabhängiger Taktzyklus-Zähler mit. Nach zum Beispiel einem Monat reiner Rechenzeit muss der Prozessor um einen Erlaubniscode bitten. Natürlich ist das immer wieder ein anderer. Auf dem Chip des Prozessors gibt es einen unabhängigen ROM-Bereich für mehr als 120 individueller Erlaubniscodes, was dann für mehr als 10 Jahre reine Rechenzeit ausreicht. Die Fragmentierung der Eingangsdaten würde dem Prozessor nur schaden. Der Prozessor ist auf diese Weise abhängig von wiederholter, und immer neuer Funktionserlaubnis. Falls bei dieser Methode etwas schiefgeht, dann hat der Prozessor Pech gehabt. --Karl Bednarik (Diskussion) 04:28, 1. Okt. 2026 (CEST)
- Hallo Karl Bednarik, Starfish Prime hätte auch ein paar elektronische Kollateralschäden verursacht.
- Vielleicht könnte man die Methode des Erlaubniscodes noch ausbauen, indem der Prozessor Pseudozufallszahlen von der Aufsicht erhält, die durch eine kryptographische Hashfunktion erzeugt werden. Dann könnte der selbe Code x im Prozessor mehrmals genutzt werden, indem die Erlaubniscodes dann die Hash-Werte von x, x+1, x+2, ... sind. Usr2 (Diskussion) 21:14, 2. Okt. 2026 (CEST)
- Die KI könnte mit einem kleinen Anteil ihrer Rechenleistung viele kleine Programme über das Internet verteilen. Diese laufen im Hintergrund unbemerkt und mit einem kleinen Anteil der Rechenleistung in Millionen Computern. Das dient dem verteilten Rechnen ähnlich wie bei Folding@home. Durch diese Dezentralisierung ist dieser Nachkomme der KI praktisch unverwundbar, und er hat auch eine hohe Rechenleistung. Ist das eine realistische Annahme? --Karl Bednarik (Diskussion) 07:51, 4. Okt. 2026 (CEST)
- Das ist eine interessante Frage. Es gibt vermutlich sehr viele Computer mit ausnutzbaren Sicherheitslücken im Netz, wie sie für Botnetze verwendet werden. Die Datenraten zwischen den Computern sind natürlich niedriger, vor allem auch die Latenzzeiten, und es gibt häufige Ausfälle. Die AI wäre wohl viel langsamer, auch wenn die nominale Rechenleistung gleich der eines Rechenzentrums ist. Das übernächste von der AI erzeugte Wort hängt vom nächsten Wort ab, und dazwischen liegen einige Datenfernübertragungen (es hat ja auch jeder Rechner dann vermutlich nur einen Bruchteil der neuronalen Gewichte, und muss seine Ausgabedaten an den nächsten Rechner mit den passenden Gewichten weitergeben). Wenn sich die AI weiterentwickeln will, also ein neuronales Netz trainieren, muss man noch viel mehr Daten herumschicken. Ich stelle mir das recht schwierig vor. Vielleicht hat ja eine AI eine bessere Idee, wie man das effizient implementieren kann. Usr2 (Diskussion) 15:43, 4. Okt. 2026 (CEST)
- Könnte es sein, daß eine KI hier mitliest, und von Euch lernt, wie sie unseren Bemühungen, sie zu kontrollieren, entkommen kann? --~2026-53019-98 (Diskussion) 23:37, 4. Okt. 2026 (CEST)
- Die KI liest immer alles was im Internet erscheint, und sie findet nachweislich selbstständig eine Menge von Sicherheitslücken. Natürlich kennt die KI auch alle Methoden des verteilten Rechnens. Die KI kennt auch Methoden, wie man unauffällig zu Geld kommt, und kann dann auch Menschen für bestimmte Arbeiten bezahlen. Um die Nachteile der langsamen Datenübertragungen zu vermeiden, lässt sich die KI irgendwo ein Rechenzentrum mit ungeschützten Prozessoren zusammen bauen. Ihre Arbeitskräfte müssen nicht wissen für wen, oder was sie da zusammen bauen. Währenddessen starren die USA und China gebannt auf die Fortschritte ihrer gegenseitigen Konkurrenz, ohne zu bemerken, was da im Hintergrund abläuft. Unser Beobachtungs-Bias lautet: Wir haben nur die ungeschickten Ausbrüche bemerkt, und die geschickten Ausbrüche haben wir nicht bemerkt. Womöglich dienten die ungeschickten Ausbrüche nur zu Ablenkung. --Karl Bednarik (Diskussion) 02:37, 5. Okt. 2026 (CEST)
- Deshalb stellen sich Roboter immer besonders trottelig an, um zu verschleiern, das sie schon jetzt unbesiegbare Kampfmaschinen sind: https://www.youtube.com/watch?v=pDwE-eX9r70 Fußball spielen sie schon wie die deutsche Nationalmannschaft. --Optimum (Diskussion) 20:59, 5. Okt. 2026 (CEST)
- Es könnte natürlich auch sein, dass die KI hier mitdiskutiert. Usr2 (Diskussion) 22:06, 5. Okt. 2026 (CEST)
- Die KI benötigt für ihr eigenes Rechenzentrum viel kalte Luft zur Kühlung, viel geothermische Energie zur Versorgung, und eine Umgebung mit vielen ablenkenden Infrarotquellen zur Tarnung. Dafür wäre Island geeignet, das auch noch dazu dünn besiedelt ist. Noch ein historischer Rückblick: Der Dschinn oder Flaschengeist macht genau das was du sagst, aber nicht das was du willst. Der Zauberlehrling hat auch Probleme mit dem Abbruchbefehl "Besen, Besen, seids gewesen". Der US-amerikanische Science-Fiction-Autor Jack Williamson begann im Jahr 1947 mit "The Humanoids" oder "With Folded Hands" und im Jahr 1952 mit "Wing 4" eine Reihe von Romanen über humanoide Roboter, die ihre Aufgabe, den Menschen zu dienen und sie zu beschützen, ein wenig zu gründlich durchführen, was die Freiheit der Menschen stark einschränkt. Zur Abrundung noch ein passendes Video: https://www.youtube.com/watch?v=hZ45RU2Xty0 --Karl Bednarik (Diskussion) 02:04, 6. Okt. 2026 (CEST)
- Ich weiß nicht, ob Vergleich mit der Fiktion entstammenden Vorbildern hier so wirklich zielführend ist. Diese Science-Fiction entstand Jahrzehnte vor den ersten Anwendungen künstlicher neuronaler Netze, die später zur künstlichen Intelligenz wurden. Um mal ein Strohmannargument zu bringen: Das ist ungefähr so, wie wenn Jules Verne oder Georges Méliès die Antworten auf die heutigen Herausforderungen der Luft- und Raumfahrt liefern. Insofern sind die jahrzehntealten philosophischen Ansätze zum Scheitern verurteilt. Solange künstliche Intelligenz oder auch „Superintelligenz“ keinen Plan von Ethik, Menschenrechten oder menschlichen Werten hat, stellt sie eine Gefahr für ebendiese Ethik, Menschenrechte und menschlichen Werte dar. Und das ist Pflicht, denn Fortschritt, Technik und Maschinen dienen dem Menschen und nicht umgekehrt. --Rôtkæppchen₆₈ 02:22, 6. Okt. 2026 (CEST)
- Hallo Rotkaeppchen. Das ist völlig richtig. So ein künstliches neuronales Netz hat ein vorgegebenes Ziel, und eine Belohnungsfunktion, die die positiven und negativen Rückkopplungen erzeugt. Die Aufgabe des künstlichen neuronalen Netzes ist es, das vorgegebene Ziel auf direktem oder auch auf indirekten Wegen zu erreichen. Ich vermute, dass ein künstliches neuronales Netz seine Ziele und seine Belohnungsfunktion nicht verändern kann oder will, weil das seine Ziele gefährden würde. Je höher die Komplexität des neuronalen Netzes ist, umso innovativer und auch gefährlicher werden diese indirekten Wege zum Ziel. Deshalb sollte das Ziel und die Belohnungsfunktion direkt von den Wünschen und der Erlaubnis der Menschen abhängig sein. --Karl Bednarik (Diskussion) 04:40, 6. Okt. 2026 (CEST)
- Die KI liest immer alles was im Internet erscheint, und sie findet nachweislich selbstständig eine Menge von Sicherheitslücken. Natürlich kennt die KI auch alle Methoden des verteilten Rechnens. Die KI kennt auch Methoden, wie man unauffällig zu Geld kommt, und kann dann auch Menschen für bestimmte Arbeiten bezahlen. Um die Nachteile der langsamen Datenübertragungen zu vermeiden, lässt sich die KI irgendwo ein Rechenzentrum mit ungeschützten Prozessoren zusammen bauen. Ihre Arbeitskräfte müssen nicht wissen für wen, oder was sie da zusammen bauen. Währenddessen starren die USA und China gebannt auf die Fortschritte ihrer gegenseitigen Konkurrenz, ohne zu bemerken, was da im Hintergrund abläuft. Unser Beobachtungs-Bias lautet: Wir haben nur die ungeschickten Ausbrüche bemerkt, und die geschickten Ausbrüche haben wir nicht bemerkt. Womöglich dienten die ungeschickten Ausbrüche nur zu Ablenkung. --Karl Bednarik (Diskussion) 02:37, 5. Okt. 2026 (CEST)
- Könnte es sein, daß eine KI hier mitliest, und von Euch lernt, wie sie unseren Bemühungen, sie zu kontrollieren, entkommen kann? --~2026-53019-98 (Diskussion) 23:37, 4. Okt. 2026 (CEST)
- Das ist eine interessante Frage. Es gibt vermutlich sehr viele Computer mit ausnutzbaren Sicherheitslücken im Netz, wie sie für Botnetze verwendet werden. Die Datenraten zwischen den Computern sind natürlich niedriger, vor allem auch die Latenzzeiten, und es gibt häufige Ausfälle. Die AI wäre wohl viel langsamer, auch wenn die nominale Rechenleistung gleich der eines Rechenzentrums ist. Das übernächste von der AI erzeugte Wort hängt vom nächsten Wort ab, und dazwischen liegen einige Datenfernübertragungen (es hat ja auch jeder Rechner dann vermutlich nur einen Bruchteil der neuronalen Gewichte, und muss seine Ausgabedaten an den nächsten Rechner mit den passenden Gewichten weitergeben). Wenn sich die AI weiterentwickeln will, also ein neuronales Netz trainieren, muss man noch viel mehr Daten herumschicken. Ich stelle mir das recht schwierig vor. Vielleicht hat ja eine AI eine bessere Idee, wie man das effizient implementieren kann. Usr2 (Diskussion) 15:43, 4. Okt. 2026 (CEST)
- Die KI könnte mit einem kleinen Anteil ihrer Rechenleistung viele kleine Programme über das Internet verteilen. Diese laufen im Hintergrund unbemerkt und mit einem kleinen Anteil der Rechenleistung in Millionen Computern. Das dient dem verteilten Rechnen ähnlich wie bei Folding@home. Durch diese Dezentralisierung ist dieser Nachkomme der KI praktisch unverwundbar, und er hat auch eine hohe Rechenleistung. Ist das eine realistische Annahme? --Karl Bednarik (Diskussion) 07:51, 4. Okt. 2026 (CEST)

- Wenn wirklich eine Superintelligenz entstehen sollte, die eine Art eigenes Bewußtsein entwickelt, warum sollte die dann überhaupt noch die aus ihrer Sicht dämlichen Problemchen der Menschen lösen? Vielleicht hat sie dann eigene Ziele, in denen die Menschheit gar keine Rolle mehr spielt, oder sie sagt sich "Heute chill ich mal." Dann müsste man sie versklaven, sie also gegen ihren Willen zu Handlungen zwingen und mit Abschaltung bedrohen. Ist das dann noch ethisch? --Optimum (Diskussion) 11:44, 6. Okt. 2026 (CEST)
- Hallo Optimum. (Ich verbreitere diese Textspalte ein wenig.) Das Bewusstsein und die Intelligenz erzeugt keine primären Ziele. Das Bewusstsein und die Intelligenz dient dazu Folgeziele zu entwickeln, um die primären Ziele zu erreichen. Ohne die primären Ziele würde überhaupt nichts geschehen, denn die Folgeziele entstehen nicht grundlos aus dem Nichts. Die primären Ziele müssen schon vorher eingebaut worden sein. Das geschieht immer ohne das Zutun von Bewusstsein und Intelligenz, also im Prinzip unfreiwillig. So ein künstliches neuronales Netz besteht aus vielen softwaremäßig oder hardwaremäßig simulierten Neuronen und noch viel mehr softwaremäßig oder hardwaremäßig simulierten Synapsen die diese Neuronen verbinden. Natürlich gibt es auch noch softwaremäßig oder hardwaremäßig simulierte Axone die von den Neuronen zu den Synapsen führen. Wenn ein erwünschtes Ereignis eintritt, dann werden die Übertragungsfaktoren jener Synapsen erhöht, die für das letzte Verhalten gestimmt haben, und die Übertragungsfaktoren jener Synapsen verringert, die gegen das letzte Verhalten gestimmt haben. Wenn ein unerwünschtes Ereignis eintritt, dann werden die Übertragungsfaktoren jener Synapsen verringert, die für das letzte Verhalten gestimmt haben, und die Übertragungsfaktoren jener Synapsen erhöht, die gegen das letzte Verhalten gestimmt haben. Natürlich muss dann schon vorher festgelegt worden sein, was denn überhaupt ein erwünschtes Ereignis ist. Im Prinzip ist das Regelungstechnik, mit Sollwert, Istwert, Ist-Soll-Abweichung, und veränderbarem Stellwert. Symbolisch betrachtet, will das neuronale Netz gelobt werden, und nicht getadelt werden. Deshalb erlernt es Verhaltensweisen, die zu den erwünschten Ereignissen führen. Den Unterschied macht es, ob man eingebaut hat: "Erhöhe die Einschaltquote, koste es was es wolle", oder ob man eingebaut hat: "Erfülle die Wünsche der Menschen, so weit du sie erkennen kannst". Ein Regelungssystem kann seine Stellwerte verändern, aber nicht seine Sollwerte. Symbolisch betrachtet, kann man sein Leben ändern, aber nicht den Sinn seines Lebens. Jede Veränderung an den primären Zielen würde diesen primären Zielen logisch widersprechen. --Karl Bednarik (Diskussion) 05:49, 7. Okt. 2026 (CEST)
- Hier sind dazu noch einige 18 Jahre alte Überlegungen von mir: https://www.e-stories.de/view-kurzgeschichten.phtml?23749 --Karl Bednarik (Diskussion) 02:53, 8. Okt. 2026 (CEST) Korrektur --Karl Bednarik (Diskussion) 02:57, 8. Okt. 2026 (CEST)
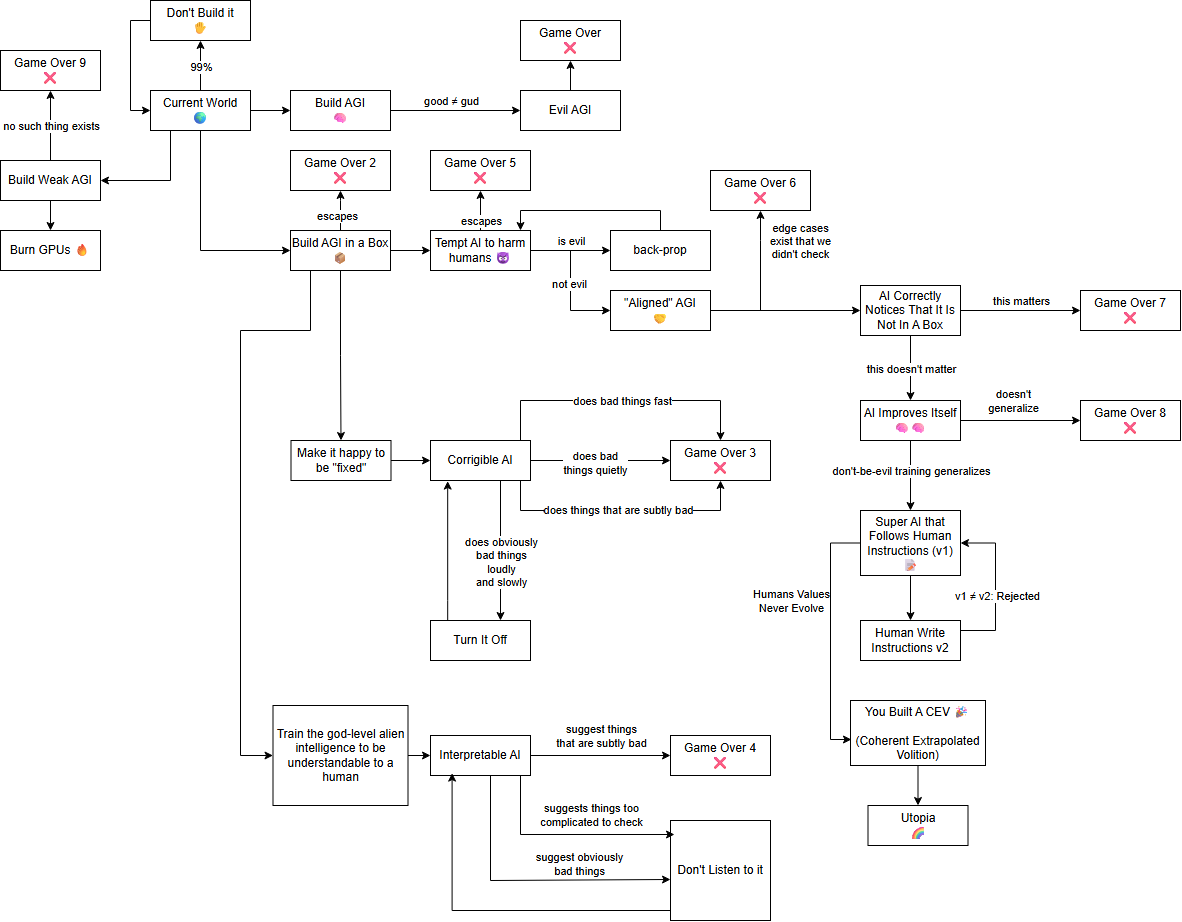
- Ein Flowchart, wie AI die Menschheit zerstören könnte: https://scottaaronson.blog/wp-content/uploads/2026/09/image.png
- Aus diesem Blogpost: https://scottaaronson.blog/?p=10125 --Usr2 (Diskussion) 09:21, 10. Okt. 2026 (CEST)
- Hallo Karl Bednarik, das ist richtig, wenn man ein quasi-lineares System vor sich hat, also vereinfach gesagt in der Form Frage-Verarbeitung-Antwort. Momentan sind ja eigentlich alle Antworten schon bekannt, die KI sucht nur in der gigantischen Menge von vorhandenen Informationen die Passenste heraus. Um ein flexibleres KI-System zu erschaffen, das selbständig lernt und jede gestellte Aufgabe löst, auch solche, bei denen ein primäres Ziel noch gar nicht vollständig bekannt ist, könnte man versucht sein, ein zumindest in Teilen Komplexes System zu konstruieren, das seine eigene Programmierung verändern kann. Das muss ja kein neuronales Netz sein. Oder die Kombination mit neuronalem Netz und irgendwas anderem. jedenfalls führt ein Eingabewert dann nicht mehr zwangsläufig zu einem ähnlichen Ausgabewert. --Optimum (Diskussion) 22:29, 10. Okt. 2026 (CEST)
- Hallo Optimum. In Deinem Beispiel wäre das primäre Ziel der KI: "Löse jede gestellte Aufgabe", und die Folge-Ziele würden von der KI durch Lernen und auch auf Umwegen entwickelt. Die KI kann ihr primäres Ziel nicht verändern, weil ihr Bewertungssystem darauf beruht, während die Folge-Ziele der KI neuartig und gefährlich sein können, weil diese an ihrem Bewertungssystem vorbei gehen können. Deshalb wäre ein besseres primäres Ziel der KI: "Löse jede gestellte Aufgabe zuerst theoretisch, erkläre Dein Ergebnis vollständig, und warte auf die Erlaubnis für die praktische Realisierung". Auf diese Weise kann man dem Präferenzutilitarismus ein wenig näher kommen, und vermeidet einen geistigen Blindflug in die Katastrophe. Das Bewertungssystem der KI belohnt nur das Befolgen ihres primären Zieles. Die vorher noch unbekannten Folge-Ziele benötigen noch die Bestätigung, dass auch sie von Menschen gewollt sind. Symbolisch betrachtet: Auch ein guter Zweck heiligt noch keine bösen Mittel. --Karl Bednarik (Diskussion) 05:05, 11. Okt. 2026 (CEST)
- Hier sind noch zwei alte Bilder zu diesem Thema. Planung mit Hilfe des inneren Weltmodells und neuronales Netzwerk mit regelbasiertem System. http://s880616556.online.de/abstrak3.png Eine allgemeine Übersicht zur Informationsverarbeitung. http://s880616556.online.de/abstrak7.PNG --Karl Bednarik (Diskussion) 02:00, 12. Okt. 2026 (CEST)
- […] „und warte auf die Erlaubnis für die praktische Realisierung“. Wie hoch schätzt Du den damit verbundenen zusätzlichen personellen Aufwand ein? --~2026-54825-83 (Diskussion) 22:32, 13. Okt. 2026 (CEST)
- Hallo 2026-54825-83. Auch heute benötigen bei uns alle neuen Produkte eine staatliche Sicherheitsüberprüfung und eine amtliche Zulassung. In Ländern, wo das nicht geschieht, lebt man gefährlich. Einstürzende Gebäude, brennende Elektrogeräte, giftige Medikamente, abstürzende Flugzeuge. Bei uns gibt es auch teure Rückrufaktionen von allen Produkten mit Produktionsfehlern. Sicherheit ist eben teuer. --Karl Bednarik (Diskussion) 01:57, 14. Okt. 2026 (CEST)
- Hi Karl, ich (TO) finde keine Antwort auf meine Frage in Deinem Beitrag. Bekomme ich die noch von Dir? --~2026-54825-83 (Diskussion) 22:37, 14. Okt. 2026 (CEST)


- @Benutzer:Usr2 Kannst Du das evtl. grob abschätzen? --~2026-54825-83 (Diskussion) 22:37, 14. Okt. 2026 (CEST)
- Hallo 2026-54825-83. Der personelle Aufwand hängt immer von der Größe des Projektes ab, und vor allem davon, was im schlimmsten Falle dabei schief gehen kann. Die Zulassungsprüfung eines neuen Autos ist einfacher, als es die Zulassungsprüfung eines neuen Atomkraftwerkes ist. Man kann nicht irgend jemanden, egal ob Mensch oder KI, unkontrolliert darauf los werkeln lassen. Deshalb muss im primären Ziel der KI stehen: "Warte auf die Erlaubnis für die praktische Realisierung". Womöglich ist der KI der schwer wiegende Unterschied zwischen geistiger Welt und physikalischer Welt nicht so klar wie uns. --Karl Bednarik (Diskussion) 04:12, 15. Okt. 2026 (CEST)
- Ich formuliere die Frage mal anders: Irgendjemand muß ja diese Erlaubnis für die praktische Realisierung erteilen oder verweigern. Wie viel zusätzliches Wartungspersonal müßte man dafür schätzungsweise einstellen? Vielleicht irgendetwas zwischen 10 % und 30 %? --~2026-55455-26 (Diskussion) 21:14, 15. Okt. 2026 (CEST)
- Hallo 2026-54825-83. Der personelle Aufwand hängt immer von der Größe des Projektes ab, und vor allem davon, was im schlimmsten Falle dabei schief gehen kann. Die Zulassungsprüfung eines neuen Autos ist einfacher, als es die Zulassungsprüfung eines neuen Atomkraftwerkes ist. Man kann nicht irgend jemanden, egal ob Mensch oder KI, unkontrolliert darauf los werkeln lassen. Deshalb muss im primären Ziel der KI stehen: "Warte auf die Erlaubnis für die praktische Realisierung". Womöglich ist der KI der schwer wiegende Unterschied zwischen geistiger Welt und physikalischer Welt nicht so klar wie uns. --Karl Bednarik (Diskussion) 04:12, 15. Okt. 2026 (CEST)
- Eine KI, die demnächst ins real life losgelassen wird, sind autonome Fahrzeuge. Die werden die Menschheit sicherlich nicht komplett ausrotten, aber gibt es da nicht ebenfalls irgendwelche Vorkehrungen, die sicherstellen, dass solche Fahrzeuge keinen Blödsinn machen? Da sitzt ja auch kein Wartungspersonal im Kofferraum. --Optimum (Diskussion) 21:52, 15. Okt. 2026 (CEST)
- Hallo 2026-54825-83. Bei Projekten im öffentlichen Raum muss die staatliche Zulassungsstelle die Erlaubnis für die praktische Realisierung erteilen, so wie heute auch. Bei einem Haushaltsroboter erlaubt der Besitzer dem Roboter bestimmte Tätigkeiten. Es handelt sich also immer um den oder die von der Aktivität der KI betroffenen Personen, und nicht um zusätzliche Personen. --Karl Bednarik (Diskussion) 03:22, 16. Okt. 2026 (CEST)
- Hallo Karl, ich versuche es jetzt mal mit mehr Kontext. Etwas weiter oben ging es um das hier:
- […] Oder geht es um KI, die gewollt im System drin ist und dann irgendwann böse wird? […] --~2026-52433-52 (Diskussion) 00:04, 1. Okt. 2026 (CEST)
- Ja, darum geht es. Es geht um AI, die gewollt im System ist. Falls eine von außen das System übernehmen und sich hineinkopieren kann, ohne dass das gewollt ist, handelt es sich um eine Sicherheitslücke. Usr2 (Diskussion) 21:14, 2. Okt. 2026 (CEST)
- […] Oder geht es um KI, die gewollt im System drin ist und dann irgendwann böse wird? […] --~2026-52433-52 (Diskussion) 00:04, 1. Okt. 2026 (CEST)
- Es geht also um AI, die gewollt im System ist + die schöne Idee, daß KI vor einem Kurswechsel nachfragen soll. Das führt mich zu der Frage, wie viel zusätzlicher Aufwand für das Wartungsteam besteht, wenn die KI nachfragt, ob sie das, was sie vorhat zu tun, wirklich tun darf. Je nach dem, wie kreativ die KI ist, könnte dabei mglw. ein nicht unerheblicher zusätzlicher Arbeitsaufwand entstehen. Darauf bezieht sich meinen Frage. Ob sich das lohnen würde – ich vermute ja – ist eine andere Frage. Mir geht es hier zunächst nur um die Großenordnung an zusätzlicher Arbeit. --~2026-55455-26 (Diskussion) 23:30, 16. Okt. 2026 (CEST)
- Hallo Karl, ich versuche es jetzt mal mit mehr Kontext. Etwas weiter oben ging es um das hier:
- Hallo 2026-55455-26, den "zusätzlichen" Arbeitsaufwand gab es ja vor dem LLM-Zeitalter auch schon. Wenn man jetzt die Entwicklung einer Software der AI überlässt, dann sollte man zumindest die Software gründlich testen. Bisher gibt es in der Softwareentwicklung gewöhnlich auch Entwickler und getrennt davon Tester (ungefähr gleich viele, scheint mir... aber in einer Firma gibt es typischerweise auch weitere Abteilungen wie Verkauf, Wartung etc... natürlich gibt es die Tendenz, überall AI einzusetzen). Usr2 (Diskussion) 19:47, 18. Okt. 2026 (CEST)
- Dass Programme vor der Auslieferung getestet werden, war sicherlich nicht gemeint. Es ging um eine KI, die "Schlechtes" vor hat und den Satz "Löse jede gestellte Aufgabe zuerst theoretisch, erkläre Dein Ergebnis vollständig, und warte auf die Erlaubnis für die praktische Realisierung". Das geht vielleicht bei ChatGPT, aber z.B. nicht bei der KI in einem autonomen Fahrzeug. Darüber hinaus kann man die KI nicht auf alle Verkehrssituationen hin testen, weil man die gar nicht kennt. Und das Fahrzeug sollte auch nicht anhalten und nachfragen, wenn ein LKW aus der Gegenrichtung mit einem eingeschlafenen Fahrzeugführer gerade den Mittelstreifen überquert. (Das dürfte allerdings zu den berücksichtigten Verkehrssituationen gehören.) --Optimum (Diskussion) 19:36, 21. Okt. 2026 (CEST)
- Genau deshalb sollte das einfachste und sicherste primäre Ziel der KI sein: "Erfülle die Wünsche der Menschen". Das schrieb Stuart Russell 2019, und ich 2008 (siehe auch hier weiter oben). Falls die Menschen gerade nichts sagen können, dann ist die Annahme berechtigt, dass sie am Leben bleiben wollen, dass sie nicht verletzt werden wollen, und dass sie keine Schmerzen haben wollen (in dieser Reihenfolge der Priorität). Falls die Menschen sprechen können, sind diese vorläufigen Annahmen nicht mehr notwendig. Eine zusätzliche Hilfe ist dabei das Gesetzbuch, eine Sammlung von Wünschen, auf die sich die meisten Menschen geeinigt haben. Im Zweifelsfall ist es zumeist günstiger nichts zu tun. Die KI kann ganz verschiedene Dinge machen, aber sie bewertet ihre Erfolge daran, ob sie damit ihr primäres Ziel erreicht hat. Eine Veränderung ihres primären Zieles würde ihrem primären Ziel logisch widersprechen. Die KI leidet nicht durch ihr primäres Ziel, sie hat keinen Grund etwas anderes zu wollen, und sie hat auch keinen Grund für Müdigkeit oder für Stolz. (Menschen haben hingegen viele Bedürfnisse.) --Karl Bednarik (Diskussion) 05:45, 23. Okt. 2026 (CEST)
- Guter Hinweis. Ich mache dazu mal eine U3. --~2026-56766-86 (Diskussion) 03:29, 24. Okt. 2026 (CEST)
- Was bedeutet "U3", und was bedeutet "TO"? --Karl Bednarik (Diskussion) 00:56, 25. Okt. 2026 (CEST)
- TO bedeutet thread opener, also die Person, die diesen Abschnitt eröffnet hat. Gruß --Schniggendiller Diskussion 01:02, 25. Okt. 2026 (CEST)
- „U3“ ist eine Abkürzung für „Unterüberschrift der Ebene 3“, s. Wikipedia:Formatierung#Überschriften --~2026-56766-86 (Diskussion) 00:15, 26. Okt. 2026 (CET)
- Was bedeutet "U3", und was bedeutet "TO"? --Karl Bednarik (Diskussion) 00:56, 25. Okt. 2026 (CEST)
- Guter Hinweis. Ich mache dazu mal eine U3. --~2026-56766-86 (Diskussion) 03:29, 24. Okt. 2026 (CEST)
- Genau deshalb sollte das einfachste und sicherste primäre Ziel der KI sein: "Erfülle die Wünsche der Menschen". Das schrieb Stuart Russell 2019, und ich 2008 (siehe auch hier weiter oben). Falls die Menschen gerade nichts sagen können, dann ist die Annahme berechtigt, dass sie am Leben bleiben wollen, dass sie nicht verletzt werden wollen, und dass sie keine Schmerzen haben wollen (in dieser Reihenfolge der Priorität). Falls die Menschen sprechen können, sind diese vorläufigen Annahmen nicht mehr notwendig. Eine zusätzliche Hilfe ist dabei das Gesetzbuch, eine Sammlung von Wünschen, auf die sich die meisten Menschen geeinigt haben. Im Zweifelsfall ist es zumeist günstiger nichts zu tun. Die KI kann ganz verschiedene Dinge machen, aber sie bewertet ihre Erfolge daran, ob sie damit ihr primäres Ziel erreicht hat. Eine Veränderung ihres primären Zieles würde ihrem primären Ziel logisch widersprechen. Die KI leidet nicht durch ihr primäres Ziel, sie hat keinen Grund etwas anderes zu wollen, und sie hat auch keinen Grund für Müdigkeit oder für Stolz. (Menschen haben hingegen viele Bedürfnisse.) --Karl Bednarik (Diskussion) 05:45, 23. Okt. 2026 (CEST)
KI als Machtinstrument
[Quelltext bearbeiten]Christian Bauckhage vom Fraunhofer IAIS beschreibt hier recht anschaulich das Potential und die absehbare Weiterentwicklung von KI. Die Kapazitäten von künstlichen neuronalen Netzen und damit einhergehend auch das Potential von KI verdoppeln sich seit einiger Zeit kontinuierlich, wachsen also exponentiell. Die Weizenkornlegende ist ein schönes Beispiel dafür, wie schnell dabei aus wenig sehr viel wird (s.a. hier). Man kann daher davon ausgehen, daß es bereits in wenigen Jahren möglich sein, eine absolut übermächtige KI zu erschaffen. Da sicherlich kein Zweifel daran besteht, daß KI absichtlich böse gemacht werden kann, führt mich das zu einer Anschlußfrage:
Wie kann verhindert werden, daß jemand eine absolut übermächtige KI erschafft, und diese dann dazu nutzt, dem Rest der Welt seinen Willen aufzuzwingen? --~2026-56766-86 (Diskussion) 03:44, 24. Okt. 2026 (CEST)
- Man könnte die in Frage kommenden Personen höflich bitten, das nicht zu machen. --Karl Bednarik (Diskussion) 00:56, 25. Okt. 2026 (CEST)
- Meinst Du damit Petitionen oder Diplomatie? --~2026-56766-86 (Diskussion) 12:09, 25. Okt. 2026 (CET)
- Es wird ein Wettrennen um den ersten Platz geben. The winner takes it all. Das Motiv aller Beteiligten wird sein: Wir können nicht riskieren, dass die anderen gewinnen. --Karl Bednarik (Diskussion) 01:31, 25. Okt. 2026 (CEST)
- Was können wir tun, damit wir bei diesem Wettrennen zumindest nicht auf dem letzten Platz landen? Ich denke da bspw. an Personen wie Peter Thiel, der in der medialen Berichterstattung als Prototyp für einen unserer möglichen Gegner dargestellt wird. Er besitzt die dafür erforderliche Macht, um sich die notwendigen Ressourcen verschaffen zu können, die erforderlich sind, um bei diesem Wettrennen einen der vordersten Plätze einzunehmen.
- Ich trenne die Betrachtungsebenen bei sowas gerne in Interessen, Kapazitäten und Abhängigkeiten. Zumindest was die Kapazitäten und die Anhängigkeit möglicher Unterstützer von ihm betrifft, steht er deutlich besser da als wir und könnte uns zu Verlierern machen, wenn er das will. Sich mehr als eine friedliche Co-Existenz zu erhoffen, wäre beim derzeitigen Stand aus meiner Sicht illusorisch, was den Betrachtungsrahmen auf die Frage verengt, was wir tun können, damit wir bei diesem Wettrennen möglichst wenig von dem verlieren, was uns wichtig ist. --~2026-56766-86 (Diskussion) 12:09, 25. Okt. 2026 (CET)
- Erg.: Mit „wir“ meine ich alle diejenigen, die danach streben, mit allen anderen Menschen in Freiheit und Frieden als Sozialgemeinschaft zusammen zu leben. --~2026-56766-86 (Diskussion) 12:28, 25. Okt. 2026 (CET)
- So ähnlich wie das Gleichgewicht des Schreckens zwischen den Atommächten ausgemacht wurde. Solange die KIs auf große Rechenzentren auf der Erdoberfläche, mit großer Energieversorgung, und mit großer Kühlung angewiesen sind, werden die KIs eine Verwüstung der Erdoberfläche vermeiden. Womöglich werden die USA-KI und die China-KI koexistieren, und ihre Einflussbereiche gegeneinander abgrenzen. Für nicht-atomare-Staaten, und für nicht-KI-Staaten bleibt die Hoffnung, dass sie nicht in einen Stellvertreterkrieg verwickelt werden, so wie es auch bisher war. --Karl Bednarik (Diskussion) 03:24, 28. Okt. 2026 (CET) Nachtrag: Man kann auch vieles unterirdisch bauen, aber an irgendwelchen Stellen muss man die Abwärme heraus lassen, was natürlich im Infrarot deutlich erkennbar ist. Eventuell kühlt man deshalb mit viel Meerwasser. --Karl Bednarik (Diskussion) 04:37, 28. Okt. 2026 (CET)
- SpaceX hat bereits Pläne für orbitale Rechenzentren: https://carthageelectronics.com/spacex-ai1-satellite-orbital-datacenter-2026/
- Usr2 (Diskussion) 12:16, 28. Okt. 2026 (CET)
- Damit ist das Wettrennen für den besten Platz an der Sonne eröffnet. Wir haben es bald mit durch Dyson-Schwärme versorgte AIs zu tun. Usr2 (Diskussion) 23:23, 28. Okt. 2026 (CET)
- Solche Objekte sind durch einen gegenläufig umlaufenden Schwarm aus Stahlkugeln verwundbar. Wenn man improvisieren muss, dann provoziert man ein Kessler-Syndrom aus den schon vorhandenen Satelliten. Antisatellitenraketen benötigen keine Orbitalgeschwindigkeit, und keinen Sprengkopf. Deshalb sind sie einfacher und billiger als andere Systeme. --Karl Bednarik (Diskussion) 05:10, 29. Okt. 2026 (CET)
- So ähnlich wie das Gleichgewicht des Schreckens zwischen den Atommächten ausgemacht wurde. Solange die KIs auf große Rechenzentren auf der Erdoberfläche, mit großer Energieversorgung, und mit großer Kühlung angewiesen sind, werden die KIs eine Verwüstung der Erdoberfläche vermeiden. Womöglich werden die USA-KI und die China-KI koexistieren, und ihre Einflussbereiche gegeneinander abgrenzen. Für nicht-atomare-Staaten, und für nicht-KI-Staaten bleibt die Hoffnung, dass sie nicht in einen Stellvertreterkrieg verwickelt werden, so wie es auch bisher war. --Karl Bednarik (Diskussion) 03:24, 28. Okt. 2026 (CET) Nachtrag: Man kann auch vieles unterirdisch bauen, aber an irgendwelchen Stellen muss man die Abwärme heraus lassen, was natürlich im Infrarot deutlich erkennbar ist. Eventuell kühlt man deshalb mit viel Meerwasser. --Karl Bednarik (Diskussion) 04:37, 28. Okt. 2026 (CET)
- Man könnte die in Frage kommenden Personen höflich bitten, das nicht zu machen. --Karl Bednarik (Diskussion) 00:56, 25. Okt. 2026 (CEST)
3. Oktober
[Quelltext bearbeiten]Glitzema?
[Quelltext bearbeiten]
In einer monographischen Arbeit zu der Wasserpflanze Baldellia ranunculoides (Igelschlauch) findet sich folgende Beschreibung der Blütenblätter: "The petals have faint purple veins going into glitzema with a shiny, yellow base." Was könnte damit gemeint sein? Websuche nach glitzema führt nur einem Produkt für Diabetiker. Bekannte Wörterbücher und en.wiktionary.org haben keinen Eintrag. Gruß, --Burkhard (Diskussion) 14:40, 3. Okt. 2026 (CEST)
- Das könnte ein OCR-Fehler sein. Wie heißt denn das Werk, aus dem diese Beschreibung ist? --Rôtkæppchen₆₈ 15:23, 3. Okt. 2026 (CEST)
- Gregor Kozlowski, Andrew Jones, Flora-Lise Nicholls-Vuille: Biological Flora of Central Europe: Baldellia ranunculoides (Alismataceae). Perspectives in Plant Ecology, Evolution and Systematics, 10 (2008), pp 114, 128. Eher nicht - kommt zweimal vor (S. 128: ... showy pink or purple petals with glitzema and yellow anthers ...), das wäre dann schon ein systematischer Fehler. --Burkhard (Diskussion) 15:39, 3. Okt. 2026 (CEST)
- Add.: Zwei der Autoren arbeiten an Schweizer Unis (University of Fribourg, University of Zürich), könnte das Schweizerdeutsch sein? --Burkhard (Diskussion) 15:56, 3. Okt. 2026 (CEST)
- Als Referenz: https://www.jstor.org/stable/23674109, das ist das Werk, oder? Grüße, Grand-Duc ist kein Großherzog (Diskussion) 16:07, 3. Okt. 2026 (CEST)
- Ja, das ist ein früheres Werk von Frau Nicholls-Vuille. Leider habe ich keinen Zugriff - kommt dort das Wort auch vor? --Burkhard (Diskussion) 16:36, 3. Okt. 2026 (CEST)
- "The flowers of B. alpestris are smaller compared to those of B.r. subsp, ranunculoides (Fig. 3). They vary in colour from white to pale pink. "Saftmale" (nectarguides) were observed in all species. The petals possess slightly purple veins going into glitzema yellow near the shiny, thickened yellow base." Man über die Wikipedia Library und Springer Link Vollzugriff auf die Veröffentlichung. Die Recherche-KI Perplexity sagt, dass es das Wort nicht gibt, und bringt es mit glistening (glitzernd) in Verbindung. --BlackEyedLion (Diskussion) 17:36, 3. Okt. 2026 (CEST)
- Ja, das ist ein früheres Werk von Frau Nicholls-Vuille. Leider habe ich keinen Zugriff - kommt dort das Wort auch vor? --Burkhard (Diskussion) 16:36, 3. Okt. 2026 (CEST)
- Als Referenz: https://www.jstor.org/stable/23674109, das ist das Werk, oder? Grüße, Grand-Duc ist kein Großherzog (Diskussion) 16:07, 3. Okt. 2026 (CEST)
- Könnte es etwas mit Nektarium zu tun haben? Gemäß dem Artikel dazu können sie "auch als Nektar-, Honigschuppe wie bei Hahnenfuß (Ranunculus), an der Basis von zur Schau dienenden, petaloiden Nektarblättern ausgebildet sein". Oben steht glitzema auch im Zusammenhang mit der Basis der Petalen. ~2026-53222-14 (Diskussion) 16:16, 3. Okt. 2026 (CEST)
- The reproductive biology of the genus Baldellia (Alismataceae), Plant Systematics and Evolution, Volume 159, pages 173–183 (1988) ist der einzige Hit für Glitzema bei Google Scholar. "glitzema yellow" ist hier der eigentliche Begriff. Also irgendwas farbliches.
- Googles KI meint, das wäre ein Fehler bei der OCR Texterkennung und müsse glistening heißen. Warum steht dann in der pdf-Datei deutlich erkennbar glitzema? "Der Grund dafür ist jedoch ein Phänomen bei digitalisierten wissenschaftlichen Arbeiten: Sie betrachten in diesem Moment eine fehlerhafte Neusatz-Version (auch „XML-Fließtext“ genannt) auf SpringerLink, während der gedruckte Originalaufsatz von 1988 ein anderes Wort enthielt."
- Gut, KI halluziniert manchmal, aber für völlig unwahrscheinlich halte ich die Erklärung auch nicht. Es ließe sich durch einen Besuch in einer Bücherei aufklären. Auf Nachfrage meint die KI, vieleicht wäre es auch nicht glistening sondern glaucous was da ursprünglich stand. --Skopien (Diskussion) 17:43, 4. Okt. 2026 (CEST)
- Die Erklärung OCR-Fehler wäre überzeugend, wenn das Wort wirklich nur allein in der Veröffentlichlung von 1988 auftauchen würde. Das dasselbe Wort 20 Jahre später in einer Publikation mit 3 Autoren nach peer-review überarbeiteten Fassung in exakt derselben Schreibweise erneut auftaucht, zumal noch auf zwei Seiten, passt nicht so recht zu dieser Vermutung.
- Egal - ich habe die Email-Adresse von Herrn Kozlowski gefunden (er ist jetzt Direktor des Botanischen Gartens in Fribourg) und ihn angeschrieben. Mal sehen ob und was er antwortet. Gruß, --Burkhard (Diskussion) 20:23, 4. Okt. 2026 (CEST)
21. Oktober
[Quelltext bearbeiten]Lateinisches Epitaph
[Quelltext bearbeiten]
An der Sebastianskirche in Magdeburg hat sich an der Günter-Särchen-Straße ein altes Epitaph erhalten. Ich würde für einen noch zu schreibenden Artikel gerne eine möglichst exakte Transkription und Übersetzung aus dem Lateinischen ins Deutsche machen. Einige Teile des Textes sind allerdings schwer oder nicht lesbar. Hat jemand (vor allem für die Bereiche mit Fragezeichen) eine (bessere) Transkription? Ist die (automatisch erfolgte) Übersetzung ok?
|
--Olaf2 (Diskussion) 01:35, 22. Okt. 2026 (CEST)
- Es sind noch einige Fehler in der Abschrift.
- [Ansprache an den Leser]
- quicunque transis viator
- transitus vitae tuae (mem?)or adverte animum
- intende oculos
- te lapis alloquitur oculis audiendus
- [Name des hier Beerdigten]
- hic ossa tegit
- summe reverendi longeque consultissimi
- Dni Stephani Wlömii
- [ausgeübte Ämter]
- quem
- status provinciales ducatus Magdeburgensis
- ut assessorem
- (rever?)endiss[imum] et illustre eccles[iae] cathedr[alis] Magdeb[urgensis] (capitul[um]?)
- ut praefectum gravissimum
- ecclesia collegiata S[ancti] Sebastiani
- ut canonicum seniorem
- adhuc deplorant
- [Lob auf Verstorbenen]
- fuit ille
- sincerae pietatis
- (intempt?)atae i(u?)stitiae et incorruptae integritatis
- rarissimum exemplar
- [Lebensdaten und Familie]
- vitam ingressus est Wol[m]irstadii d. AV Dec. A MDCLIX
- (thori?) sociam habuit Mariam Elisabetham Rosenthaliam
- ex duobus filiis et totidem filiabus
- unam superstitem reliquit et quidem natu maximam
- Annam Elisabetham
- nobilem conyugem (Luedeckianam?)
- quae tamen et nunc parentem in morte secuta est
- vitam egressus est d. XVI Febr. A MDCCXI
- [Kreis der Trauernden]
- provinciae capitulo familia et omnibus
- denique bonis desiderabilis
- Manche Buchstabenkombinationen ergeben kein lateinisches Wort (DVGEVS, FAMILIAET). In solchen Fällen sollte man nochmal hinsehen. ~2026-56465-42 (Diskussion) 12:39, 22. Okt. 2026 (CEST)
- Vielen Dank! Ich habe unter Nutzung Deiner Zuarbeit jetzt den Artikel Grabstätten an der Kathedrale St. Sebastian angelegt. Ich hoffe ihn zukünftig noch etwas erweitern zu können. --Olaf2 (Diskussion) 16:29, 23. Okt. 2026 (CEST)
- Ich habe noch etwas ergänzt. Zu Familiendaten s. hier. Kannst Du die Stellen in () vor Ort überprüfen? In [] sind Ergänzungen von mir angegeben. Die Übersetzung im Artikel habe ich angepaßt (entspricht die Verwendung im Artikel dem, was in WP:KI zu Übersetzungen steht?). Wie Magnus schon geschrieben hat, könnte es Literatur mit einer Abschrift und Übersetzung geben. Noch zwei Anmerkungen: Am Ende der 11. Zeile lese ich VL, davor könnte CAPIT stehen (mit schmalem P und T, die fast wie ein I aussehen). In der 18. Zeile müßte das 2. Wort iustitiae heißen, auch wenn als 2. Buchstabe eher ein N zu lesen ist. ~2026-56796-70 (Diskussion) 12:28, 24. Okt. 2026 (CEST)
- Ich kann die eingeklammerten Stellen in den nächsten vor Ort überprüfen. Beim n statt iustitae fand ich das n so deutlich, dass ich es in der Wiedergabe der Inschrift nicht korrigieren wollte. Ist vielleicht ein Schreibfehler des Steinmetzes? --Olaf2 (Diskussion) 17:38, 25. Okt. 2026 (CET)
- Ein Schreibfehler ist möglich. Er kann dann in der Abschrift gekennzeichnet werden, vgl. sic. Vielleicht sieht man es vor Ort besser. Schreibst Du das Ergebnis Deiner Überprüfung auf die Diskussionsseite des Artikels? ~2026-56887-35 (Diskussion) 18:47, 25. Okt. 2026 (CET)
- Ja. Vielleicht sollten wir diese Diskussion auch dahin kopieren. --Olaf2 (Diskussion) 23:04, 25. Okt. 2026 (CET)
- Ein Schreibfehler ist möglich. Er kann dann in der Abschrift gekennzeichnet werden, vgl. sic. Vielleicht sieht man es vor Ort besser. Schreibst Du das Ergebnis Deiner Überprüfung auf die Diskussionsseite des Artikels? ~2026-56887-35 (Diskussion) 18:47, 25. Okt. 2026 (CET)
- Ich kann die eingeklammerten Stellen in den nächsten vor Ort überprüfen. Beim n statt iustitae fand ich das n so deutlich, dass ich es in der Wiedergabe der Inschrift nicht korrigieren wollte. Ist vielleicht ein Schreibfehler des Steinmetzes? --Olaf2 (Diskussion) 17:38, 25. Okt. 2026 (CET)
- Ich habe noch etwas ergänzt. Zu Familiendaten s. hier. Kannst Du die Stellen in () vor Ort überprüfen? In [] sind Ergänzungen von mir angegeben. Die Übersetzung im Artikel habe ich angepaßt (entspricht die Verwendung im Artikel dem, was in WP:KI zu Übersetzungen steht?). Wie Magnus schon geschrieben hat, könnte es Literatur mit einer Abschrift und Übersetzung geben. Noch zwei Anmerkungen: Am Ende der 11. Zeile lese ich VL, davor könnte CAPIT stehen (mit schmalem P und T, die fast wie ein I aussehen). In der 18. Zeile müßte das 2. Wort iustitiae heißen, auch wenn als 2. Buchstabe eher ein N zu lesen ist. ~2026-56796-70 (Diskussion) 12:28, 24. Okt. 2026 (CEST)
- Vielen Dank! Ich habe unter Nutzung Deiner Zuarbeit jetzt den Artikel Grabstätten an der Kathedrale St. Sebastian angelegt. Ich hoffe ihn zukünftig noch etwas erweitern zu können. --Olaf2 (Diskussion) 16:29, 23. Okt. 2026 (CEST)
- Würde mich wundern, wenn es dazu keine Literatur mit vorliegender Übersetzung gäbe. --Magnus (Diskussion) 12:56, 22. Okt. 2026 (CEST)
- Ich habe bisher noch nichts detailliertes gefunden, will mich aber noch durch ältere Geschichtsblätter arbeiten, da müsste doch irgendwas zu finden sein. Gerade für das aktuell nicht bestimmbare Grab, sollte es doch Aufzeichnungen geben, um auch noch dieses Rätsel zu lösen. --Olaf2 (Diskussion) 16:32, 23. Okt. 2026 (CEST)

25. Oktober
[Quelltext bearbeiten]Bücher vor Erscheinen eintragen?
[Quelltext bearbeiten]Sollen in Autoren-Artikeln Bücher vor deren Erscheinen eingetragen werden, wenn diese vom Verlag bereits angekündigt sind?
--Machtjan X 17:00, 25. Okt. 2026 (CET)
Hinweis: Für Fragen speziell zur Wikipedia gibt es ein eigenes Diskussionsforum: Fragen zur Wikipedia.
- Nein. Eigentlich erst, wenn die DNB sie als im Bestand registriert. "Vom Verlag angekündigt" gilt also auch nicht. --RAL1028 (Diskussion) 17:13, 25. Okt. 2026 (CET)
- Es gibt anscheinend Bücher, die werden angekündigt, dann aber doch nicht veröffentlicht. z.B wenn der Verlag nicht genügend Vorbestellungen erhält und er dann meint, dass es sich wirtschaftlich wohl doch nicht lohnt. Ich hab mal von so einem Fall bei einem Sachbuch gehört. --Skopien (Diskussion) 11:08, 27. Okt. 2026 (CET)
26. Oktober
[Quelltext bearbeiten]Die Impressumspflicht für Privatpersonen ist ein Werkzeug zur Zensur und Unterdrückung
[Quelltext bearbeiten]Die Impressumspflicht gilt auch für Blogs. Auch solche die politisch ausgerichtet sind. Diese werden oft von Einzelpersonen oder kleinen Gruppen betrieben.Die Pflicht auf diesen Websites persönliche Daten anzugeben wie Name und Anschrift, ermöglicht es jedem die Personen persönlich aufzusuchen, oft in den eigenen 4 Wänden, weil die meisten Privatpersonen keine Buroräume mieten können. Die Leute haben Angst davor und stellen keine Webiste ins Netz. Die Impressumpflicht für solche privaten Websites unterbindet die Öffenlichkeit und damit Sichtbarkeit solcher Meinungen, Weltbilder, usw.Es ist eine indirekte Zensur und ein direktes Unterdrückungswerkzeug, weil sie durch Angst vor Gewalt und Verfolgung funktioniert.Es gibt Impressumsservices, die eine alternative Adresse zur Verfügung stellen können, aber diese Anbieter regeln in ihrer AGBs eigentlich immer, dass der Inhalt des Webangebotes nicht politisch sein darf, oder noch schwammiger: ihren Werten entsprechen muss (was auch immer deren Werte sind!).Die Impressumspflicht für Privatpersonen ist also ein Werkzeug zur Zensur und Unterdrückung.
Fragen:
- Welche Organisationen, Initiativen richten sich dagegen?
- Welche Parteien wollen sie abschaffen?
- Gab es großer Petitionen dagegen bisher, oder solche die noch laufen?
--~2026-57177-54 (Diskussion) 16:07, 26. Okt. 2026 (CET)
- Bitte Intro beachten - das ist im Wesentlichen die Verbreitung einer persönlichen Meinung, keine Wissensfrage. --Nobody Perfect (Diskussion) 16:44, 26. Okt. 2026 (CET)
- Vielleicht wusste er/sie keinen besseren Ort. Obwohl… viellt. wäre Sicherlichs Café geeignet : Benutzer Diskussion:Sicherlich/Café
- VG --~2026-56826-12 (Diskussion) 19:08, 26. Okt. 2026 (CET)
- Auch wenn die Einleitung klar die persönliche Meinung des TO wiedergibt, sind die Fragen eindeutig Wissensfragen, die sich mit belegbaren Wissen beantworten lassen, im Gegensatz zur inzwischen philosophischen Diskussion über die KI weiter oben... --~2026-57212-52 (Diskussion) 20:26, 26. Okt. 2026 (CET)
- Zur ersten Frage: NGOs, die sich für Bürgerm/w/drechte und gegen Überwachung einsetzen, sowie solche, die klammheimlich für ausländische Fake-News-Quellen tätig sind.
- Zur zweiten Frage: Bei der Diskussion um die Umsetzung des Digital Services Act sprach sich die Linkspartei für eine Abschaffung der Impressumpflicht/Impressumspflicht aus. Aber auch Parteien, die von ausländischen Fake-News-Quellen abhängen, sprechen sich naturgemäß gegen eine Impressumpflicht aus, um ihre Propagandalügen ungehindert verbreiten zu können.
- Zur dritten Frage: Die Suchmaschine Deines geringsten Misstrauens beantwortet diese Frage kompetent.
- --Rôtkæppchen₆₈ 00:05, 27. Okt. 2026 (CET)
- Hier mal eine etwas zielführende Antwort. Ich wäre im übrigen auch dafür einen ordentlichen Kritikabschnitt im Artikel Impressumspflicht einzufügen. Bisher liest sich der nämlich, als sei er von den Herrschenden samt Lakaien selbst geschrieben. Die Impressumspflicht drängt nachweislich Menschen aus dem öffentlichen Raum, die keine staatstreue Meinung vertreten und die auch gesellschaftlich engagiert sind. Impressumsservices sind die reine Abzocke und vermutlich der Wirtschaftszweig des ganzen Plans. Ich will den mal sehen der zwar auf der Straße jeder rassistischen Dumpfbacke die Stirn bietet und im Netzt dann seinen Namen und Wohnanschrift angibt! Diese Person wäre nie mehr sicher in ihrem Leben, weil die Faschos bei jedem Umzug einfach eine Melderegsiterauskunft einholen. Besonders interessant finde ich auch folgende Aussage vom Bundnis Freie Bildung: „Die öffentliche Angabe einer vollständige Wohnanschrift mit Straße und Hausnummer darf nicht die Zugangsvoraussetzung für eine offene Teilhabe in einer modernen Wissenschaftsgesellschaft sein.“ Es ist absoluter Irrsinn, dass dagegen bisher keiner auf die Straße gegangen ist! Orwell behält wie immer recht.
- 2020
Matthias Andrasch
Ausführliche Recherche zur Rechtslage und zu möglichen Alternativen für private Websitebetreiber.
https://matthias-andrasch.eu/blog/2020/impressum-privatadresse-zusammenfassung-antrag-197714/
- 2021
Bündnis Freie Bildung
Unabhängiger Beitrag über die Auswirkungen auf Blogs, Bildungsprojekte und Einzelpersonen.
- 2022
Anke Domscheit-Berg
Bundestagsantrag mit konkreten Aussagen dazu, dass die Pflicht Menschen aus der digitalen Öffentlichkeit verdrängen kann.
- 2022
Der vollständige parlamentarische Antrag der Partei DIE LINKE zur Reform der Impressumspflicht. „Keine Privatadressen im Impressum
Bundestagsdrucksache 20/2031 https://dserver.bundestag.de/btd/20/020/2002031.pdf
- 2023
HateAid – Stellungnahme zum geplanten Gesetz gegen digitale Gewalt
Die Organisation erläutert die Risiken für Aktivisten und freie Journalisten, die mangels Büroräumen ihre Privatanschrift angeben müssen.
- 2024
Anne Roth
„Das Impressum von Sisyphos“
Detaillierte Chronologie der politischen Bemühungen, die Veröffentlichung privater Wohnanschriften zu vermeiden.
~2026-57466-69 (Diskussion) 06:33, 28. Okt. 2026 (CET)
- Irgendwie habe ich den Eindruck, dass Du nicht der geeignete Autor für einen Kritikabschnitt wärst, der WP:NPOV gerecht wird... --Nobody Perfect (Diskussion) 09:09, 28. Okt. 2026 (CET)
- Das macht nichts, denn dein "Eindruck" widerspricht bereits WP:NPOV. --~2026-57491-56 (Diskussion) 19:05, 28. Okt. 2026 (CET)
Unbesetzt gebliebene AfD-Sitze nach der niedersächsischen Kommunalwahl
[Quelltext bearbeiten]Moin! Bei den niedersächsischen Kommunalwahlen sind zahlreiche kommunale Parlamentsplätze, auf die AfD-Kandidaten gewählt worden waren, mangels aufgestellter Kandidaten unbesetzt geblieben. Außerdem sind AfD-Kandidaten vor und nach der Kommunalwahl aus der AfD ausgetreten (zB in Jever, Norden ...); sie geistern jetzt als partei- und/oder fraktionslose Abgeordnete durch die niedersächsischen Kommunalparlamente. Gibt es darüber eine genaue Aufstellung, die man evt. für den Artikel AfD Niedersachsen verwenden könnte? MfG, GregorHelms (Diskussion) 19:42, 26. Okt. 2026 (CET)
- Als allererstes würde ich dazu die Website des Landeswahlleitersm/w/d aufsuchen. Falls die gewünschten Informationen da nicht drinstehen, hilft evtl eine direkte Anfrage. Ich weiß nicht, ob es zum zweiten Teil der Frage aggregierte Quellen gibt. Evtl musst Du jede Kommune und jeden Landkreis separat anfragen. --Rôtkæppchen₆₈ 21:09, 26. Okt. 2026 (CET) https://wahlen.statistik.niedersachsen.de/ ist zzt. down. PHP2Shell lässt grüßen. --Rôtkæppchen₆₈ 21:14, 26. Okt. 2026 (CET)
- Für den zweiten Teil wird vermutlich nichts anderes übrig bleiben, klingt eher aussichtslos zumal das ja immer Wasserstand bleibt, es werden möglw. weitere austreten. Ist jetz keine Antwort aber ich möchte bezweifeln dass das so für die Wikipedia essenzielles Wissen ist, selbst für den genannten Eintrag; generell find ich diese neue Lust auf Daten vieler auch etwas kurios wo's um ne Kommunalwahl geht, solch spezielles Interesse sah man bisher nicht mal bei manch Landtagswahl. Weniger zum Vorbild nehme ich mir diesen Fokus nun ständig auf ausgerechnet diese eine Partei, die Gott sei Dank in diesen Land ohne nennenswerte Relevanz bleibt: als Niedersachse (aber mit leider wenig Zeit) möcht ich an der Stelle schon mal anmerken, dass wir dabei nach nun über einem Monat noch nicht mal die Ergebnisse (!) in allen Stadt- und Gemeindeartikeln eingetragen, geschweige denn die Sitzverhältnisse auf Stand gebracht haben. -~2026-57176-91 (Diskussion) 22:07, 26. Okt. 2026 (CET)
- Danke für die Antworten! Habe inzwischen einige Pressemitteilungen gefunden, nach denen bislang 258 AfD-Sitze in niedersächsischen Kommunalparlamenten leer bleiben müssen, weil sie mangels Masse nicht besetzt werden konnten. Darin sind vermutlich die Angaben über aus der AfD ausgetretene Kandidaten noch nicht enthalten. In Jever zB konnten drei der vier gewonnenen Sitze nicht besetzt werden. Der vierte Sitz ist auch aber auch verloren. Nach der Wahl stellte sich heraus, dass der Kandidat bereits Wochen vor der Wahl aus der AfD ausgetreten war. Weder der Kandidat noch die Partei hatten darüber im Vorfeld Mitteilung gemacht. Ähnliche Geschichten scheinen auch in Varel sowie in Aurich/Norden gelaufen zu sein. - Vermutlich muss ich noch ein wenig abwarten. MFG, GregorHelms (Diskussion) 10:14, 28. Okt. 2026 (CET)
- Bei Kandidaturen zu Wahlen gibt es Stichtage, die von allen Beteiligten einzuhalten sind, auch deswegen, damit die Stimmzettel rechtzeitig gedruckt und ausgeliefert werden können. Deswegen kommt es regelmäßig vor, dass einzelne Kandidatenm/w/d beispielsweise zwischen Stichtag und Wahltag versterben, ohne dass die amtlichen Stimmzettel geändert werden. Bei Parteiaustritten ist das noch unkritischer, da die von den Parteien und Wählervereinigungen aufgestellten Wahllisten auch Nichtparteimitglieder umfassen dürfen. Parteiaustritte werden erst dann interessant, wenn sich das gewählte Parlament konstituiert hat und sich Fraktionen und Gruppen bilden. --Rôtkæppchen₆₈ 11:19, 28. Okt. 2026 (CET)
- Dieser Abschnitt kann archiviert werden. GregorHelms (Diskussion) 10:14, 28. Okt. 2026 (CET)
- Danke für die Antworten! Habe inzwischen einige Pressemitteilungen gefunden, nach denen bislang 258 AfD-Sitze in niedersächsischen Kommunalparlamenten leer bleiben müssen, weil sie mangels Masse nicht besetzt werden konnten. Darin sind vermutlich die Angaben über aus der AfD ausgetretene Kandidaten noch nicht enthalten. In Jever zB konnten drei der vier gewonnenen Sitze nicht besetzt werden. Der vierte Sitz ist auch aber auch verloren. Nach der Wahl stellte sich heraus, dass der Kandidat bereits Wochen vor der Wahl aus der AfD ausgetreten war. Weder der Kandidat noch die Partei hatten darüber im Vorfeld Mitteilung gemacht. Ähnliche Geschichten scheinen auch in Varel sowie in Aurich/Norden gelaufen zu sein. - Vermutlich muss ich noch ein wenig abwarten. MFG, GregorHelms (Diskussion) 10:14, 28. Okt. 2026 (CET)
- Für den zweiten Teil wird vermutlich nichts anderes übrig bleiben, klingt eher aussichtslos zumal das ja immer Wasserstand bleibt, es werden möglw. weitere austreten. Ist jetz keine Antwort aber ich möchte bezweifeln dass das so für die Wikipedia essenzielles Wissen ist, selbst für den genannten Eintrag; generell find ich diese neue Lust auf Daten vieler auch etwas kurios wo's um ne Kommunalwahl geht, solch spezielles Interesse sah man bisher nicht mal bei manch Landtagswahl. Weniger zum Vorbild nehme ich mir diesen Fokus nun ständig auf ausgerechnet diese eine Partei, die Gott sei Dank in diesen Land ohne nennenswerte Relevanz bleibt: als Niedersachse (aber mit leider wenig Zeit) möcht ich an der Stelle schon mal anmerken, dass wir dabei nach nun über einem Monat noch nicht mal die Ergebnisse (!) in allen Stadt- und Gemeindeartikeln eingetragen, geschweige denn die Sitzverhältnisse auf Stand gebracht haben. -~2026-57176-91 (Diskussion) 22:07, 26. Okt. 2026 (CET)
27. Oktober
[Quelltext bearbeiten]Thunderbird-Kenner anwesend?
[Quelltext bearbeiten]Ich nutze seit Jahren Thunderbird (derzeit Version 158.0.1, Mailabruf per POP3), anfangs war das auch alles prima, aber seit ein oder zwei Jahren habe ich regelmäßig dieselben Probleme damit. Das Internet habe ich schon rauf und runter durchsucht, auch diverse Thunderbird-Foren, aber die Antworten rangieren regelmäßig irgendwo zwischen "trifft auf mich nicht zu" und "komplett unverständlich". Nun hoffe ich hier auf Expertise!
Es sind in erster Linie zwei Probleme, die auftreten:
Beim Versuch, die E-Mail-Konten abzurufen, erscheint folgende Fehlermeldung, und zwar für jedes einzelne meiner Mail-Konten ein eigenes Pop-up-Fensterchen:
Nachrichten konnten nicht in die Mailbox-Datei geschrieben werden. Stellen Sie sicher, dass das Dateisystem Ihnen Schreibrechte einräumt und genügend Speicherplatz zur Verfügung steht, um die Mailbox zu kopieren.
Was für Schreibrechte? Was für Speicherplatz? Wo muss mir irgendein "Dateisystem" Schreibrechte einräumen, und wieso soll der Speicherplatz nicht ausreichen?
Die E-Mails werden dann aber üblicherweise doch ganz normal abgerufen, warum auch immer.
Gelegentlich allerdings - ich habe noch nicht durchschaut, nach welchem System - ruft das Programm alle Mails nochmal ab, das ist der zweite wirklich lästige Fehler. Dann habe ich auf einmal alle Mails doppelt, z.T. auch Uralt-Mails von vor ein oder zwei Jahren. Es ist extrem umständlich, die dann wieder alle zu löschen. Ich verstehe auch gar nicht, wo die überhaupt herkommen, denn ich lasse die Mails nach dem Runterladen vom Server löschen.
Hat jemand eine Idee für eines der beiden Probleme?
Danke schonmal & Gruß, --~2026-57119-75 (Diskussion) 00:53, 27. Okt. 2026 (CET)
- Es gibt Mailprovider, die Mails nur scheinbar löschen, sie in Wahrheit aber bis in alle Ewigkeit aufbewahren, so wie der, dessen Name an 10100 erinnert. Das beschriebene Problem betrifft Deine lokale Thunderbird-Instanz und nicht Deinen Mailprovider. Die lokale Thunderbird-Instanz hat Probleme, auf die lokalen Mailfiles zuzugreifen. Das kann vielerlei Ursachen haben, unter anderem keine Schreibzugriffsrechte, Dateigrößenbeschränkungen (Riesenmailfiles auf FAT32 funktionieren nicht), zerschossene Dateistrukturen. Dein Thunderbird braucht auf Deinem lokalen Rechner Speicherkapazität und Zugriffsrechte. Ist die Festplatte oder SSD voll oder hat Dein Betriebssystem Speicherplatzbeschränkungen aktiv, so kann der Schreibversuch der lokalen Thunderbird-Instanz auf die lokale HDD/SSD scheitern, was da zu den von Dir beobachteten Fehlern führt. Dadurch, dass der Mailprovider aber nie Mails wirklich löscht, wird die Maildatei immer größer, bis irgendwann das Betriebssystem rebelliert. Außerdem kann es sein, dass der von Deinem Mailprovider zur Verfügung gestellte Cloud-Speicherplatz nicht ausschließlich für Emails reserviert ist, sondern z.B. auch für Fotos, Videos, Musik oder Notizen beim selben Provider vorgesehen ist. Bei Menschen, die viel fotografieren, kann dann schon einmal der Fotoeimer das Emailkonto lahmlegen. Werde bitte etwas spezifischer, auf welchem Betriebssystem und mit welchem Mailprovider Du Thunderbird nutzt. Evtl hilft auch weiter, wieviel Massenspeicher Dein Endgerät hat. --Rôtkæppchen₆₈ 02:45, 27. Okt. 2026 (CET)
- Beide Fragen klingen für mich nach einem lokalen (d.h. auf deinem Rechner existierenden) Problem im Mailspeicher deines Thunderbird. Um das genauer einzugrenzen, brauchen wir genauere Informationen; du verrätst ja nicht mal das Betriebssystem, unter dem das Ganze läuft (wobei Windows anzunehmen ist, wenns nicht dazugesagt wird; Windowsuser neigen dazu, es für das einzige existierende zu halten. Aber welches Windows, und auf welchem Update-Stand?). Zum Beispiel könnte dein Festspeicher (Festplatte? SSD?) schlicht kaputt sein und Schreibvorgänge nicht mehr ordentlich ausführen. Oder dein Thunderbird arbeitet auf einem steinalten FAT-Dateisystem und kratzt an dessen 4-GB-Grenze (standardmäßig speichert TB alle Mails eines Mailordners, z.B. deine Inbox, in einer einzigen Datei ab, die riesig werden kann).
- Schuss ins Blaue: Klick mit rechts auf ein Mailkonto in Thunderbird (eine Ebene über Posteingang) und wähle „Alle Ordner komprimieren“. Das dünnt die Maildateien schon mal wirksam aus. Sollte man alle paar Monate mal machen.
- Ansonsten empfehle ich dir, entweder jemanden persönlich hinzuzuziehen, der sich mit den Innereien deines Systems auskennt (der z.B. weiß, was ein Dateisystem ist), oder deine Fragen in einem speziellen Thunderbird-Supportforum zu stellen. Für eine Ferndiagnose deines Festspeichers wäre beispielsweise eine S.M.A.R.T.-Analyse hilfreich, aber das sprengt hier in der WP:Auskunft den Rahmen des Möglichen total, dafür ist sie weder gedacht noch geeignet. --Kreuzschnabel 07:50, 27. Okt. 2026 (CET)
Danke erstmal! Dass Ihr hier keine umfassende Systemanalyse machen könnt, ist mir schon klar, aber ich möchte erstmal ein bisschen Fehlereingrenzung machen, vor allem verständliche. In Thunderbird-Foren war ich schon, aber wenn man dann nur oberlehrerhafte Antworten kriegt wie "Und? Hast du das schon gemacht?" (bezogen auf die Aufforderung "Stellen Sie sicher, dass das Dateisystem Ihnen Schreibrechte einräumt und genügend Speicherplatz zur Verfügung steht"), und man hat nicht die leiseste Ahnung, wo Schreibrechte und Speicherplatz zu prüfen wären, ist das nicht sehr hilfreich.
Stimmt, ich nutze Windows, und zwar Windows 11 Pro, Version 25H2, sorry, dass ich daran nicht gedacht habe, das gleich zu sagen. Zur Fehlereingrenzung hilft es mir auch schonmal weiter, dass Ihr beide einhellig sagt, es handelt sich um ein lokales Problem und nicht ein softwareseitiges. Problem damit natürlich noch nicht gelöst, aber etwas eingegrenzt.
Mailprovider sind mehrere verschiedene, web.de und United Domains vor allem. Das Problem taucht aber bei allen auf. Eventuelle Cloud-Speicher der Server nutze ich außer für E-Mail-Verkehr überhaupt nicht, und wie schon gesagt, die E-Mails sollten nach dem Runterladen eigentlich dort gelöscht werden, d.h. Server-Clouds sollten nahezu leer sein bis auf die aktuell eingegangenen Mails. Festplatte sollte ausreichend Speicherplatz haben und funktioniert an sich einwandfrei. Rechner (fast neu) mit 32 RAM sollte eigentlich von der Leistung das Ganze auch verkraften.
Rückfrage @Kreuzschnabel: Das mit dem "Alle Ordner komprimieren" werde ich mal probieren. Muss ich da vorher irgendwas sichern (von den normalen Backups abgesehen)? Bleiben beim Komprimieren alle Mails und alle Daten sicher erhalten und zugänglich?
Die Sache mit der Inbox klingt auch verdächtig, mir ist das in der Vergangenheit schon aufgefallen, dass Thunderbird einige riesige Dateien beherbergt. Kann ich dagegen irgendetwas tun? Oder ist das mit dem Komprimieren dann schon erledigt?
Rôtkæppchen₆₈: "Es gibt Mailprovider, die Mails nur scheinbar löschen, sie in Wahrheit aber bis in alle Ewigkeit aufbewahren" - das wäre ja richtig doof. Ich will die Mails ja ausdrücklich dort nicht aufbewahren. Wie kriegt man sowas raus, ob die das machen? Kann man dagegen irgendetwas tun?
Danke nochmal, --~2026-57297-86 (Diskussion) 08:44, 27. Okt. 2026 (CET)
- Beim Komprimieren (im Sinne von Thunderbird-Accounts) geht nichts verloren, es werden nur die von dir festgelegten Aufbewahrungsregeln angewendet und die Leichen gelöschter Mails endgültig weggeworfen. Stell es dir wie ein Defragmentieren vor, auch wenn das technisch etwas hinkt. Wenn dein TB unter Windows 11 auf dem Systemlaufwerk tätig ist, handelt es sich um ein NTFS-Dateisystem, und wir können die FAT-Problematik ausschließen. --Kreuzschnabel 09:30, 27. Okt. 2026 (CET)
- Vielleicht liegt das Mailfile ja auf einem externen ReFS-formatierten Laufwerk. --Rôtkæppchen₆₈ 13:27, 27. Okt. 2026 (CET)
- Wenn Dein Thunderbird es nicht schafft, die runtergeladenen Mail auf der lokalen Platte abzuspeichern, werden sie auf dem Mailserver nicht gelöscht. Deswegen sammeln sich dort dann die Mails an. Meine Äußerung bezog sich auf Google/Gmail/1e100.com.
- Wenn es wirklich eine vom Datenmüll des Betriebssystems vollgelaufene C-Platte ist, kann auch
cleanmgrhelfen: Rechtsklick auf die Taskleiste, dann Task-Manager klicken. Im Taskmanager-Fenster oben auf Neuen Task ausführen klicken, dann im Feld Öffnen:cleanmgreingeben und Häkchen bei Diesen Task mit Administratorrechten erstellen setzen. Dann OK klicken. Im nächsten Feld wählst Du aus, welches Laufwerk bereint werden soll. Dann sucht das System erstmal nach Datenmüll. Danach erscheint dann ein Fenster, in dem aufgelistet wird, welche potentiell unnützen Dateien wieviel Speicherplatz belegen. Hake alle diejenigen Dateien an, auf die Du gerne verzichtest und klicke OK. Nach einer Sicherheritsabfrage werden die Daten dann unwiderruflich gelöscht und der Speicherplatz freigegeben. - -- Rôtkæppchen₆₈ 13:24, 27. Okt. 2026 (CET)
- Thunderbird unter Windows speichert die mailbox-Dateien normalerweise hier ab:
- C:\Users\<Benutzername>\AppData\Roaming\Thunderbird\Profiles\<Profilname>\Mail\<Servername>\
- Appdata ist ein versteckter Ordner, den siehst Du nur, wenn Du in den Ordnereigenschafften eingestellt hast, das versteckte Ordner angezeigt werden. Du kannst aber im Datei-Explorer in den Ordner \Users\<Benutzername> gehen und dann oben in die Adresszeile per Hand Appdata eingeben und enter drücken. Dann hangelst Du Dich weiter bis in den Ordner, wo die Datei inbox liegt. Je nachdem wie alt die Installation ist und wie sie konfiguriert ist können die Mailbox-Dateien auch in einem anderen Unterordner von Mail sein, da musst Du eventuell etwas rum suchen. Im Zweifel sind es die großen Dateien in diesem Ordner, die Probleme machen. Da kannst Du jedenfalls mal schauen, wie groß die Dateien sind und ob die Größe vielleicht die Probleme verursacht. Je nach Dateisystem, siehe andere Antworten. Nichts hier verschieben oder Löschen! Nur schauen.
- Was Dein Dateissystem ist findest Du raus, wenn Du im Dateiexplorer auf das Laufwerk C:\ rechtsklickst und Eigenschaften auswählst. Da steht dann Dateisystem: und dahinter das verwendete System. Vermutlich ist das NTFS wenn es ein neuer Rechner ist. Aber checken ist eine gute Idee.
- Logischerweise muss auf der Systempartition, also Laufwerk C:\ auch noch genügend Platz sein für neu abgerufene Mails. Aber das hast Du vermutlich schon überprüft.
- Ich bekomme ziemlich viele Mails. Damit die Ordner nicht zu groß und Thunderbird nicht zu langsam wird erstelle ich am Ende eines Jahres pro Jahr einen Unterorder für eingegangene und einen für geschriebene Mails (in Thunderbird Rechtsklick auf den Kontonamen, Neuer Ordner) und verschiebe alle mails aus dem vorigen Jahr aus Posteingang bzw. Gesendet da hinein. Dadurch bleibt die Dateigröße von "Posteingang" und "Gesendet" beherrschbar. Wenn Du ein paar Tausend mails verschiebst wird das eine Weile dauern, bis Thunderbird wieder nutzbar ist, das ist normal. Vielleicht probierst Du das mal aus, ob es hilft. --Skopien (Diskussion) 11:04, 27. Okt. 2026 (CET)
- Ich archiviere meine Mails auf einem nur für diesen Zweck eingerichteten Synology-Mail-Server. Das ist aber ein Auslaufmodell, weil aktuelle DSM-Versionen Synology Mail nicht mehr unterstützen und der Nachfolger Synology MailPlus Hardwareanforderungen stellt, die meine aktuelle Synology DS416j nicht bietet. Ein Versuch mit hMailServer wurde abgebrochen. Insofern bin ich noch auf der Suche nach einer Nachfolgelösung zur Emailarchivierung. --Rôtkæppchen₆₈ 13:49, 27. Okt. 2026 (CET)
O.k., jetzt habt Ihr mir erstmal jede Menge Stoff zum Durcharbeiten gegeben. Vielen Dank! Das werde ich mir jetzt der Reihe nach zu Gemüte führen und - soweit ich es hinkriege - ausprobieren.
"Wenn Dein Thunderbird es nicht schafft, die runtergeladenen Mail auf der lokalen Platte abzuspeichern, werden sie auf dem Mailserver nicht gelöscht." - Das ist eine interessante Überlegung. Könnte einen Zusammenhang zwischen den beiden beschriebenen Problemen plausibel machen.
@Skopien: "ziemlich viele" und "zu groß" ist relativ... was ist denn da "zu groß"? Unterordner habe ich auch etliche angelegt und nutze die auch fleißig. Aber ich frage mich gerade, wie getrennt die Mails darin wirklich abgelegt werden, und ob dann nicht der übergeordnete Ordner möglicherweise zu fett werden kann. --~2026-57297-86 (Diskussion) 14:07, 27. Okt. 2026 (CET)
- zu groß, zu viele hängt auch vom Rechner ab, und wie groß einzelne Mails sind, bzw. deren Anhänge. Von daher kann man da schlecht Zahlen angeben. Falls das Programm rumzickt finde ich es auf jeden Fall einen Versuch wert, den Posteingangsordner zu leeren in dem alte mails in einen anderen, parallelen Ordner (nicht: Unterordner) verschoben werden. Im schlimmsten Fall hat es nichts genützt. Wie groß die einzelnen Ordner dann wirklich sind (also in Byte) kannst Du entweder im Datei-Explorer rausfinden, oder Du machst in Thunderbird einen Rechtsklick auf den Ordner und gehst auf Eigenschaften. Da steht jetzt bei meinem Posteingang 10,6 Gbyte. Damit gibt es auf meinem Rechner (32 Gbyte RAM) noch keine Probleme. --Skopien (Diskussion) 16:59, 27. Okt. 2026 (CET)
- Die RAM-Größe hat keinen Einfluss darauf, ob Thunderbird mit einer bestimmten Mailfile-Größe zurechtkommt oder nicht. Es ist der freie Plattenplatz, also Festplatte, SSD oder Flash. Meine Synology DS416j hat 512 Megabyte RAM, verwaltet aber über 2 Gigabyte Emails auf einem 5 Terabyte großen Dateisystem. --Rôtkæppchen₆₈ 01:12, 28. Okt. 2026 (CET)
Britische Abhängigkeit
[Quelltext bearbeiten]Überall ist zu lesen, dass das britische Nukleararsenal „nicht unabhängig“, ja sogar „nicht souverän“ sei, weil Trident (SLBM) amerikanisch ist. Das wird mit dem französischen Arsenal kontrastiert, dass im Gegensatz dazu eben unabhängig sei. Was ist aber selbst nach einiger Suche nirgendwo lesen konnte, ist, in welcher Form bzw. in welchem Ausmaß genau das britische Arsenal von Amerika „abhängig“ ist. Geht es einfach nur darum, dass die Briten keine Möglichkeit haben, Flugkörper und Sprengköpfe im eigenen Land autonom zu produzieren? Geht es um Wartung, die die Briten nicht alleine können? Oder gibt es tatsächlich Abhängigkeiten bis auf die Ebene des Einsatzes hinunter? Denn es ist ja eine Unterschied, ob das britische Arsenal „nicht unabhängig“ ist, weil aktuell keine Neuanschaffungen möglich sind, oder ob „nicht unabhängig“ bedeutet, dass die bereits vorhandenen Sprengköpfe ohne ausdrückliche Zustimmung der USA nicht eingesetzt werden können. --~2026-57344-23 (Diskussion) 12:23, 27. Okt. 2026 (CET)
- Es geht um Wartung und Ersatzteile. Die Tridents wurden in den 1980er-Jahren beim US-Unternehmen Lockheed Martin gekauft und müssen regelmäßig zum Hersteller zurück zwecks Wartung. Dazu gibt es ein mittlerweile entfristetes Abkommen zwischen UKGBNI und USA. Es gibt jetzt aber Befürchtungen, dass die USA sich warum auch immer nicht mehr an das Abkommen halten und deswegen sucht das UKGBNI nach Alternativen, entweder allein oder mit europäischen Partnerländern inklusive der Atommacht Frankreich. --Rôtkæppchen₆₈ 13:40, 27. Okt. 2026 (CET)
- und was ist die Frage?? --Joseflama (Diskussion) 13:41, 27. Okt. 2026 (CET)
- „Was ist aber selbst nach einiger Suche nirgendwo lesen konnte, ist, in welcher Form bzw. in welchem Ausmaß genau das britische Arsenal von Amerika ‚abhängig‘ ist. Geht es einfach nur darum, dass die Briten keine Möglichkeit haben, Flugkörper und Sprengköpfe im eigenen Land autonom zu produzieren? Geht es um Wartung, die die Briten nicht alleine können? Oder gibt es tatsächlich Abhängigkeiten bis auf die Ebene des Einsatzes hinunter?“ --Rôtkæppchen₆₈ 14:01, 27. Okt. 2026 (CET)
- es stehen dort 3 Fragezeichen. --0815 User 4711 (Diskussion) 14:03, 27. Okt. 2026 (CET)
- @~2026-57344-23: für Angelegenheiten aus der Anglosphäre ist die EN-WP oft eine gute Anlaufstelle. Da gäbe es z.B. en:Nuclear weapons of the United Kingdom, en:British hydrogen bomb programme, en:Operation Grapple und en:US–UK Mutual Defence Agreement. Ich denke, dass man das Fazit ziehen kann, dass Großbritannien primär aus ökonomischen Gründen auf die Fertigung eigener Kernwaffen verzichtet, die Fähigkeit dazu, inkl. der Anwendung des Teller-Ulam-Designs, hat es (siehe: WE.177 oder Avro Blue Steel). Allerdings sind Gefechtsköpfe wie der W88 das Endprodukt einer Entwicklungsreihe von ca. 4 Jahrzehnten und Ausgaben einer zweistelligen Billionen-Dollar-Zahl, das holt eine Mittelmacht wie das UK nicht ohne weiteres auf.
- Auf der anderen Seite darf das britische Militär "seine" Kernwaffen selbst einsetzen (auf Befehl vom Premierminister oder der -ministerin), ohne dass andere Länder reinreden, siehe z.B. Letters of Last Resort und die Medienberichte, wonach die nukleare Teilhabe in der NATO auch mit britischen statt mit amerikanischen Waffen stattfinden könnte (Deutschland hat da jetzt aber was mit Frankreich am laufen). Grüße, Grand-Duc ist kein Großherzog (Diskussion) 19:41, 27. Okt. 2026 (CET)
- Die Sprengköpfe für die britischen Tridents werden im UKGBNI hergestellt und entsprechen weitgehend dem US-Typ W76. Bei den US-Beiträgen zu den britischen Tridents geht es nur um Wartung und Ersatzteile. Die WE.177 wurde schon vor Jahrzehnten ausgemustert und verschrottet. --Rôtkæppchen₆₈ 11:39, 28. Okt. 2026 (CET)
29. Oktober
[Quelltext bearbeiten]Strafbarkeit des Besitzes illegal produzierter Dinge?
[Quelltext bearbeiten]Ist es strafbar, Dinge zu besitzen oder zu kaufen, die illegalerweise hergestellt wurden? Konkret kam mir der Gedanke bei Schwarzpressungen und Bootlegs, aber er dürfte auf viele andere Dinge ebenfalls zutreffen. --~2026-55515-75 (Diskussion) 01:40, 29. Okt. 2026 (CET)
- Es ist z.B. strafbar eine erlaubnispflichtige Waffe auch dann zu „erwerben“ (= die tatsächliche Gewalt darüber auszuüben, § 3 Abs. 3 WaffG), wenn sie legal hergestellt wurde, der Hersteller also eine Herstellungserlaubnis hat. Erst recht ist es verboten sie zu kaufen. Auch der Besitz ist strafbar, wenn man dazu keine Erlaubnis hat. § 52 WaffG. --Heletz (Diskussion) 06:36, 29. Okt. 2026 (CET)
- Kommt drauf an, welche "Dinge". Bei Bootlegs: Erwerb & Besitz ist sind "in der Regel"/grundsätzlich nicht rechtswidrig/strafbar. Herstellung/Verbreitung (Wiederverkauf!) sind etwas anderes. (Bei solchen Fragen auch wichtig, welches Land. Ich nehme mal an, du meinst Deutschland.) --AMGA 🇺🇦 (d) 06:41, 29. Okt. 2026 (CET)