


Monade (Informatik)
In der funktionalen Programmierung ist eine Monade ein abstrakter Datentyp. Monaden werden hauptsächlich zur Modellierung von Computer-Berechnungen (engl. computations) in Sprachen ohne Nebeneffekte verwendet[1]. Computer-Berechnungen unterscheiden sich von mathematischen Berechnungen dahingehend, dass das Berechnungsergebnis nicht einzig und allein dem „reinen“ (engl. pure) Wert der Berechnung entsprechen muss[2]. Es sind auch Fehler oder andere Effekte denkbar, u. a., dass man
- einen oder keinen Wert erhält (Maybe-Monade),
- einen Fehlerwert oder den Berechnungswert bekommt (Either-Monade),
- kein, ein oder viele Ergebnisse gleichzeitig (Nichtdeterminismus) zurückbekommt (List-Monade),
- Systemzustände berücksichtigen muss (State-Monade) oder
- Ein-/Ausgabeoperationen benötigt (IO-Monade).
Ebenso lassen sich auf diese Art Operationen über Kollektionen oder deren Kombinationen ausdrücken. Man kann beispielsweise die Listen einfach als Listen auffassen und muss nicht der Interpretation als Simulation von Nichtdeterminismus folgen.
Monaden gewährleisten durch ihre Struktur und die zugehörigen Gesetzmäßigkeiten, dass man konsistent und Kompositionsprinzipien entsprechend mit beiden Interpretationen umgehen kann.
Wesentliche Eigenschaft von Monaden ist die Fähigkeit der Übertragung von Werten und Berechnungen eines „einfacheren“ Typs auf Berechnungen eines „höheren“ Typs, der mittels eines Typkonstruktors aus dem einfacheren Typ hervorgeht, sowie die Verknüpfung mehrerer solcher Übertragungen zu einer einzigen.
„Höherer“ Typ bedeutet hier, dass der Typ (mindestens) einen Typparameter braucht, um zu einem konkreten Typen zu werden. Ein Beispiel ist die (typhomogene) Liste, deren Elemente in ihrer Definition nur einen abstrakten, nicht weiter eingeschränkten, Typ besitzen (List(A) mit Elementen des abstrakten Typs A), der jedoch in bestimmten Situationen festgelegt werden muss. Beispielsweise braucht man eine Liste von ganzen Zahlen, um deren Summe zu berechnen sum : List(Int) → Int. Andererseits kann man die Länge einer Liste auch für abstrakte Elemente berechnen, weil man nicht direkt mit den Elementen operieren muss, length : List(A) → Int. (Der Doppelpunkt kennzeichnet eine Typsignatur, hier einen Funktionstyp. Links vom Pfeil steht, was in die Funktion als Eingabe eingeht, rechts davon das Ergebnis. Die Klammern um A oder Int werden in Sprachen wie Haskell oder Agda weggelassen.)
Hintergrund
[Bearbeiten | Quelltext bearbeiten]Das Konzept der Monade stammt aus der Kategorientheorie, einem Zweig der Mathematik, welcher mathematische Objekte mittels Morphismen oder Funktoren untersucht. Die Wörter Monade oder aber auch Funktor sind wiederum von Konzepten in der Philosophie abgeleitet.
Einführende Beispiele in verschiedenen Sprachen
[Bearbeiten | Quelltext bearbeiten]Die Programmiersprachen Haskell und Agda sind funktionale Sprachen, die Monaden stark einsetzen und versuchen, monadische Kompositionen zu vereinfachen, beispielsweise durch syntaktischen Zucker (u. a. die sogenannte do-Notation).
Im Folgenden werden (unvollständige) Beispiele mit Hauptaugenmerk auf der monadischen Berechnung vorgestellt, um zu zeigen, wie sich Berechnungen eines einfachen Typen (der natürlichen Zahlen) auf einen höheren Typen (Maybe oder List) übertragen:
maybeInt₁ maybeInt₁′ maybeInt₂ : Maybe ℕ  -- ℕ natürliche Zahlen: 0, 1, 2, ...
maybeInt₁ = do  -- just 53
  x ← return 3  -- return 3 ist "just 3", aber x ist 3
  y ← return 5  -- return 5 ist "just 5", aber y ist 5
  return (x + y * 10)  -- return (...) gibt "just 53" zurück
maybeInt₁′ = bind (just 3)
                  (λ x → bind (just 5)
                              (λ y → return (x + y * 10)))
-- λ x → ... steht für eine anonyme Funktion mit einem Parameter "x".
maybeInt₂ = do  -- just 9
  x ← return 3
  y ← return (length (0 ∷ 3 ∷ 5 ∷ []))  -- Liste [0, 3, 5]
  z ← if x + y ≤ᵇ 6 then just y else nothing
  return (z + y + x)
Man kann mit x und y arbeiten, ohne Fallunterscheidungen durchführen zu müssen. maybeInt₁ und maybeInt₁′ sind äquivalent. do und ← sind Vereinfachungen für den Aufruf der bind-Funktion (s. u.). Kommt bei maybeInt₂ noch ein Element zur Liste in y hinzu, erhält man insgesamt nothing.
listInt₁ : List ℕ  -- Liste natürlicher Zahlen
listInt₁ = do
  x ← 1 ∷ 2 ∷ 3 ∷ []
  y ← 7 ∷ 8 ∷ 9 ∷ 10 ∷ []
  return (x + 3 * y)
-- 22 ∷ 25 ∷ 28 ∷ 31 ∷ 23 ∷ 26 ∷ 29 ∷ 32 ∷ 24 ∷ 27 ∷ 30 ∷ 33 ∷ []
listInt₁′ = bind (1 ∷ 2 ∷ 3 ∷ [])
                 (λ x → bind (7 ∷ 8 ∷ 9 ∷ 10 ∷ [])
                             (λ y → return (x + 3 * y)))
-- λ x → ... steht für eine anonyme Funktion mit einem Parameter "x".
listInt₂ : List ℕ
listInt₂ = do
  x ← 5 ∷ 6 ∷ []
  y ← 3 ∷ 2 ∷ 1 ∷ []
  (x + 3 * y) ∷ (2 * x + y) ∷ []
-- 14 ∷ 13 ∷ 11 ∷ 12 ∷ 8 ∷ 11 ∷ 15 ∷ 15 ∷ 12 ∷ 14 ∷ 9 ∷ 13 ∷ []
Auch hier sind x und y wieder vom einfachen Typ (ℕ) und man kann mit ihnen genauso verfahren. Man muss auch keine einelementige Liste per return zurückgeben, siehe listInt₂. listInt₁ und listInt₁′ sind äquivalent. do und ← sind Vereinfachungen für den Aufruf der bind-Funktion (s. u.). In C++ würde der Code für listInt₁′ wie folgt dargestellt werden:
list<int> myints{1, 2, 3};
list<int> myotherints{7, 8, 9, 10};
list<int> result =
bind_list<int, int>(myints, [myotherints](int x) { return
bind_list<int, int>(myotherints, [x](int y) { return
return_list(x + 3*y); }); });
Auch hier werden anonyme Funktionen genutzt und x und y sind int-Variablen, die ohne Fallunterscheidung jeden Wert der Listen durchlaufen.
Auch die Ein-/Ausgabeoperationen in Haskell oder Agda werden durch Monaden modelliert:
greeting : IO ⊤  -- Ein/Ausgabeoperationen
greeting = do
  putStrLn "Gib bitte Deinen Namen ein:"
  name ← getLine
  putStrLn ("Hallo " ++ name ++ "!")
Der Typ ⊤ (gesprochen "top") ist der Einheitstyp mit einem einzigen Konstruktor tt.
Definition und Erläuterungen
[Bearbeiten | Quelltext bearbeiten]Die übliche Formulierung einer Monade in der Programmierung hat folgende Komponenten:
- Ein Typkonstruktor, der für jeden zugrunde liegenden Typ definiert, wie der korrespondierende Monadentyp zu erhalten ist. Der Name dieses Typkonstruktors wird dabei oft synonym mit der ganzen Monade verwendet. Wenn M der Name der Monade und A der Datentyp ist, so ist M A der korrespondierende monadische Typ. Beachte, dass A selbst auch wieder aus der Monade gebildet werden kann. (Beispiel Liste: Hier ist
Listder Typkonstruktor, A der Datentyp und List A der monadische Typ, eine Liste von A. A selbst kann auch wieder List B sein.) - Eine Einheitsfunktion, die einen Wert des zugrunde liegenden Typs auf den Wert des korrespondierenden Monadentyps abbildet. Das Ergebnis ist der „einfachste“ Wert im korrespondierenden Typ, der sich aus dem Originalwert gewinnen lässt. In Haskell wird diese Funktion
returngenannt. Die Einheitsfunktion hat den polymorphen Typ A → M A. (Beispiel Liste: die Funktion hat den Typ A → List A und macht aus einem A eine einelementige Liste.) - Mindestens eine weitere Operation (siehe dazu die folgenden Abschnitte), welche die Verknüpfung monadischer Operationen beschreibt.
Hier wird kurz eine an der Kategorientheorie angelehnte Definition in Agda vorgestellt, die alle erforderlichen Merkmale zusammenfasst. Eine Monade besteht aus einem Funktor M von einer Kategorie in sich (mitsamt der Morphismenabbildung fmap) und zwei natürlichen Transformationen, Einheit return vom Identitätsfunktor auf M und Multiplikation join von M verkettet mit M auf M. Alles zusammen wird in einem record gesammelt:
record Monad : Set₁ where
  field
    M      : Set → Set                    -- Typkonstruktor (z. B. List, Maybe usw.)
    return : ∀{A}   → A       → M A       -- nat. Transformation "Einheit"
    join   : ∀{A}   → M (M A) → M A       -- nat. Transformation "Multiplikation"
    fmap   : ∀{A B} → (A → B) → M A → M B -- zu M gehörige Morphismenabbildung
    -- Monadengesetze fehlen hier erst mal
  _>>=_    : ∀{A B} → M A → (A → M B) → M B -- "bind"
  ma >>= f = (join ∘ (fmap f)) ma           -- "∘" ist die Verkettung von Funktionen
Die sog. Bind-Operation >>= (s. u.) wird durch die anderen Funktionen definiert. Set steht stellvertretend für „kleine“ Typen wie Bool, Int, String usw. Set₁ ist der Typ von Set und damit ein Ausdruck des „höheren“ Typs, der oben erwähnt wurde. ∀{A B} steht für implizite Argumente, deren Typ Agda selbst einsetzen kann. Aus der Definition von M „weiß“ Agda, dass A und B beide vom Typ Set sind. Für jede Monade muss jedes Feld im record definiert werden. Insbesondere muss auch M bekannt sein. Falls die Monadengesetze auch im record stehen, müssen die Beweise mitgeliefert werden. Das ist in Haskell nicht notwendig. Beachte, dass dort M, A und B klein geschrieben werden müssen. Diese Definition ist nur zur Darstellung gedacht, wie man eine Monade selbst definieren könnte. Die einzelnen Bestandteile werden im Folgenden definiert und erläutert.
Die folgenden Operationen sind typisch für Monaden und können für deren Definition Verwendung finden. Zur Beschreibung werden die Typsignaturen angegeben. Die Implementierung der einzelnen Funktionen obliegt dem Programmierer:
- Die natürliche Transformation „Einheit“ oder Einheitsfunktionmacht aus einem einzigen („reinen“) Wert einen monadischen Wert. Beispiel Liste:
return : A → M A
returnmacht aus einem Wert eine einelementige Liste mit genau diesem Wert. Wenn man in der Interpretation der Computerberechnungen bleibt, beschreibt die Einheitsfunktion, wie man aus einer mathematischen Berechnung eine Computerberechnung macht. - Die natürliche Transformation „Multiplikation“, welche ein „Abflachen“ des monadischen Typs um eine Verschachtelungsebene erlaubt. Beispiel Liste: Hier wird aus einer verschachtelten Liste eine einfache Liste gemacht. Dabei bestimmt aber die Eigenschaft „natürliche Transformation“, was zulässig ist, damit die Monadengesetze erfüllt bleiben.
join : M (M A) → M A
- Der Morphismenabbildung des Funktors
Merlaubt, einen monadischen Typ an eine Funktion zu übergeben, die nur den zugrundeliegenden Typ verwendet. Das erste Argument ist eine Funktion f, die von einem beliebigen Typ A auf einen beliebigen Typ B abbildet. Das zweite Argument ist ein monadischer Wert, dem der Typ A des Argumentes von f zugrunde liegt. Der Rückgabewert ist vom monadischen Typ, dem der Typ B des Rückgabewertes von f zugrunde liegt. Beispiel Liste:fmap : (A → B) → M A → M B
fmapbenötigt eine Funktion, die aus einem A ein B macht und gibt gleichzeitig an, wie man aus einer Liste von A eine Liste von B macht. Z. B. könntefaus einemInteinenStringmachen und damit aus einer Liste von ganzen Zahlen eine Liste von Strings. - Der (infix-)bind-Operatorerlaubt, einen monadischen Typ an eine Funktion zu übergeben, die nur den zugrundeliegenden Typ verwendet. Sein erstes Argument ist ein Wert von monadischem Typ und sein zweiter ist eine Funktion, die vom zugrunde liegenden Typ des ersten Arguments auf einen anderen monadischen Typ abbildet. Der Rückgabewert ist vom anderen Monadentyp. Beispiel Liste:
_>>=_ : M A → (A → M B) → M B
bindbekommt eine Liste mit Elementen des Typs A und muss als zweiten Parameter angeben, wie man aus einem einzigen Element der Eingangsliste eine Liste von Elementen des Typs B macht. Das kann z. B. durch Ignorieren des A und Verwenden vonreturnpassieren oder auch indem man bei Zahlenreturnverwendet und A und B miteinander verrechnet. Man kann auch das A duplizieren und dann in B umwandeln. - Der (Infix-)Kleisli-Operator realisiert eine Komposition (Hintereinanderausführung) für Funktionen, die einen monadischen Typ zurückgeben, aber nur den jeweils zugrundeliegenden Typ verwenden. Hier kann man sich am zweiten Argument für
_>=>_ : (A → M B) → (B → M C) → (A → M C)
bindorientieren.
Monadengesetze (Auswahl)
[Bearbeiten | Quelltext bearbeiten]Die folgenden Gesetzmäßigkeiten sind Aussagen über die in der Monade verwendeten Funktionen in Form von Gleichungen. Die Gleichungen sind punktweise zu verstehen. Sie sind alle in der Form (x : X) → L x ≡ R x gegeben. Das ist als "Für alle x aus X gilt L x gleich R x." zu lesen.
Da die Monade M auch ein Funktor ist, müssen die Funktorgesetze erfüllt sein. Diese machen Aussagen über die Kompatibilität von fmap mit der Verkettung von Funktionen und der Identitätsfunktion:
- Kompatibilität von Identitätsfunktion und
fmap(Beispiel Liste: Wenn man die Identitätsfunktion(ma : M A) → fmap id ma ≡ id ma -- kurz: fmap id ≡ id
id(Agda, Haskell:id = λ x → x, Python:id = lambda x: x) auf jedes einzelne Listenelement anwendet, erhält man dasselbe Ergebnis, als wenn man die Identitätsfunktion auf die gesamte Liste anwendet.) - Kompatibilität von Verkettung und
fmap(Beispiel Liste: Wenn man die Verkettung von(ma : M A) → fmap (f ∘ g) ma ≡ ((fmap f) ∘ (fmap g)) ma -- kurz: fmap (f ∘ g) ≡ (fmap f) ∘ (fmap g)
fundg(also erstgdannf) auf jedes einzelne Listenelemente anwendet, erhält man dasselbe Ergebnis, als wenn man erstgeinzeln auf jedes Listenelement anwendet und dannf.)
Weiterhin sind return und join natürliche Transformationen verschiedener Funktoren aufeinander. (Wenn M : Set → Set ein (Endo-)Funktor ist, dann ist auch λ A → M (M A) : Set → Set ein Endofunktor. Ebenso ist der Identitätsfunktor Id = λ A → A ein Endofunktor.) Daher erfüllen beide Funktionen die Natürlichkeitsbedingungen:
returnist eine natürliche Transformation vom Identitätsfunktor Id A auf M A(Beispiel Liste: Wenn man aus einem A-Wert eine einelementige Liste macht und auf das einzelne Element die Funktion(a : A) → ((fmap f) ∘ return) a ≡ (return ∘ f) a -- kurz: (fmap f) ∘ return ≡ return ∘ f
fanwendet, ist das dasselbe, als wenn manfauf den A-Wert anwendet und daraus eine einelementige Liste macht.)joinist eine natürliche Transformation von M (M A) auf M A(Beispiel Liste: Wenn man eine Liste von Listen abflacht und bei der abgeflachten Liste auf jedes Einzelelement(mma : M (M A)) → ((fmap f) ∘ join) mma ≡ (join ∘ ((fmap ∘ fmap) f)) mma -- kurz: (fmap f) ∘ join ≡ join ∘ ((fmap ∘ fmap) f)
fanwendet, ist das dasselbe, als wenn manfauf jedes Einzelelement jeder Teilliste anwendet und danach die Liste abflacht.)
Die Monade muss zusätzlich zu den Funktorgesetzen sowie den Natürlichkeitsbedingungen von return und join auch noch die sog. Monadenaxiome erfüllen.
- (Beispiel Liste: Falls man eine Liste von Listen von Listen hat, erhält man das gleiche Ergebnis, wenn man zweimal
(mmma : M (M (M A))) → (join ∘ (fmap join)) mmma ≡ (join ∘ join) mmma -- kurz: join ∘ (fmap join) ≡ join ∘ join
joinanwendet und wenn man auf die oberste Listenebene perfmapjoinanwendet und danach ein letztesjoin.) - (Beispiel Liste: Wendet man auf eine Liste
(ma : M A) → (join ∘ return) ma ≡ id ma -- kurz: join ∘ return ≡ id
returnan, erhält man eine einelementige Liste mit einer Liste. Nutzt man nunjoin, erhält man die Originalliste wieder zurück.) - (Beispiel Liste: Wendet man auf eine Liste ein
(ma : M A) → (join ∘ (fmap return)) ma ≡ id ma -- kurz: join ∘ (fmap return) ≡ id
fmap returnan, erhält man eine Liste von einelementigen Listen. Nutzt man nunjoin, erhält man die Originalliste wieder zurück.) - (Beispiel Liste: Dieses Gesetz bedeutet, dass wenn man beide nichttriviale Seiten der Gleichung oben auf eine Liste anwendet, man dieselbe Liste in beiden Fällen zurückerhält.)
(ma : M A) → (join ∘ (fmap return)) ma ≡ (join ∘ return) ma -- kurz: join ∘ (fmap return) ≡ join ∘ return
Die Bind-Operation erfüllt ein Assoziativgesetz und return fungiert als Neutralelement:
- „Assoziativität“ von
>>=(ma : M A) → (ma >>= f) >>= g ≡ ma >>= ( λ a → ((f a) >>= g) )
- Neutralität von
returnunter>>=(ma : M A) → ma >>= return ≡ ma (a : A) → (return a) >>= f ≡ f a
Der Kleisli-Operator erfüllt auch ein Assoziativgesetz und auch hier ist return ein Neutralelement:
- Assoziativität von
>=>(a : A) → ((f >=> g) >=> h) a ≡ (f >=> (g >=> h)) a
- Neutralität von
returnunter>=>(a : A) → (f >=> return) a ≡ (return >=> f) a -- ≡ f a
Die Gesetzmäßigkeiten, die hier angegeben sind, stellen eine Auswahl dar. Da die Bind-Operation und der Kleisli-Operator hier zusätzlich zu den Funktionen fmap, return und join definiert wurden, kann man deren Gesetze auch aus den Gesetzen dieser drei Funktionen ableiten. In diesem Sinne ist der Minimalsatz der Gesetze durch die Funktorengesetze, die zwei Natürlichkeitsbedingungen sowie die Monadenaxiome gegeben.
Die Gesetze sind in Form von Gleichungen angegeben. In manchen Sprachen kann man sie formal beweisen. In Haskell oder Sprachen mit einem schwächeren Typsystem sind die Gesetze als Eigenschaftstests aufzufassen.
Beachte: Es gibt keine allgemeine Funktion extract : M A → A für beliebige Endofunktoren M, die aus monadischen Werten wieder "reine" Werte macht. Die join-Funktion flacht nur ab, aber die Werte bleiben weiterhin monadisch. Für spezielle Monaden kann es solche Funktionen jedoch geben.
Verschiedene Definitionsmöglichkeiten über Typklassen in Haskell
[Bearbeiten | Quelltext bearbeiten]Im Folgenden werden Beispiele präsentiert, wie man Monaden auf verschiedene Weisen in Haskell über die dort verfügbaren Typklassen definieren kann. Typklassen repräsentieren den oben genannten abstrakten Datentyp. Man muss nach ihrer Definition später sog. Instanzen der Typklasse für eine konkrete Monade definieren.
In Anlehnung an Haskell
[Bearbeiten | Quelltext bearbeiten]In Haskell wird eine Monade über die Operationen return und (>>=) definiert:
class Monad m where
  return ::   a -> m a
  (>>=)  :: m a -> (a -> m b) -> m b
Die anderen Operationen lassen sich dann über diese beiden definieren:
(f >=> g) a = f a >>= g
(fmap f) ma =  ma >>= (return . f)
   join mma = mma >>= id
Über den Kleisli-Operator
[Bearbeiten | Quelltext bearbeiten]Eine Monade lässt sich auch über ihre Kleisli-Kategorie definieren:
class Monad m where
  return ::  a -> m a
  (>=>)  :: (a -> m b) -> (b -> m c) -> (a -> m c)
Die übrigen Operationen ergeben sich dann wie folgt:
   ma >>= f = (id >=>  f)  ma
     fmap f =  id >=> (return . f)
       join =  id >=> id
Analog zur Kategorientheorie
[Bearbeiten | Quelltext bearbeiten]In der Kategorientheorie wird eine Monade (die auch ein Funktor ist) üblicherweise über die Morphismenabbildung des Funktors fmap sowie zwei natürliche Transformationen return und join definiert:
class Monad m where
  fmap   :: (a -> b) -> m a -> m b
  return ::       a  ->  m a
  join   ::  m (m a) ->  m a
Die übrigen Operationen lassen sich dann wie folgt realisieren:
   ma >>= f = (join . (fmap f)) ma
    f >=> g =  join . (fmap g) . f
Beziehungen zu anderen Typklassen
[Bearbeiten | Quelltext bearbeiten]Jede Monade ist auch ein Applikativer Funktor und mithin auch ein Funktor. Umgekehrt gilt das nicht.
Diese Eigenschaft fand sich aus historischen Gründen nicht explizit in Haskells Standardbibliothek, der Glasgow Haskell Compiler hat dies jedoch mit Version 7.10 eingeführt.[3]
Besonders deutlich wird diese Beziehung auch, vergleicht man die kategorientheoretische Definition mit der Funktor-Klasse in Haskell:
class Functor f where
  fmap   :: (a -> b) -> f a -> f b
Dabei muss fmap ebenfalls die Kompatibilitätsbedingung mit der Komposition (.) erfüllen.
Beispiele
[Bearbeiten | Quelltext bearbeiten]Behälter
[Bearbeiten | Quelltext bearbeiten]Container wie Listen, Mengen, Multimengen stellen Monaden dar, deren Bindeoperation die übergebene Funktion auf alle Elemente anwendet und die dabei erhaltenen Ergebnisse vereinigt. Die Vereinigungsoperation ist dabei jeweils Listenverkettung, Vereinigungsmengenbildung bzw. Bildung der Multimengenvereinigung. Die Einheitsfunktion ergibt Einermengen und -listen.
Hier als Beispiel die Monade für verkettete Listen. Das Konzept der Instanz für Listen ist es, eine Liste einzulesen, dann jedes Element an die Funktion zu übergeben und die Ergebnisse zu verbinden. Hier eine Beispielimplementation in Haskell:
-- Hier nochmal zur Erinnerung, der Listentyp ist folgendermaßen definiert:
data [a] = [] | a:[a]
-- Als syntaktischer Zucker kann [a,b,c] für a:b:c:[] verwendet werden.

instance Monad [] where
--return :: a -> [a]
  return a = [a] -- Per Definition eine Liste mit einem Element zurückgeben
--(>>=) :: [a] -> (a -> [b]) -> [b]
  liste >>= f  = concat zwischenergebnis where -- Die einzelnen Teillisten zusammenfügen
    zwischenergebnis :: [[b]]
    zwischenergebnis = map f liste -- Die Funktion auf die Liste abbilden
Die Listen-Monade kann auch unter Verwendung von Templates in C++ implementiert werden:
// g++ --std=c++17 -o template-listmonad template-listmonad.cpp
#include <iostream>
#include <list>
#include <functional>
#include <tuple>

using namespace std;

template <typename T> list<T> return_list(T t)
{
    // einelementige Liste
    return list<T>{t};
}

template <typename T> list<T> join_list(list<list<T>> ll)
{
    // Liste wird "abgeflacht"
    list<T> flattened{};
    for (auto l : ll)
        for (auto v : l)
            flattened.push_back(v);
    return flattened;
}

template <typename A, typename B> list<B> fmap_list(function<B(A)> f, list<A> as)
{
    // aus einer Liste as wird eine Liste bs, die mit Hilfe von f berechnet werden
    list<B> bs{};
    for (A a : as)
        bs.push_back(f(a));
    return bs;
}

template <typename A, typename B> list<B> bind_list(list<A> ma, function<list<B>(A)> f)
{
    // Definition der bind-Operation mit join und fmap
    return join_list(fmap_list(f, ma));
}

template <typename T> void show_list(list<T> l)
{
    for (auto v : l)
        cout << v << " ";
    cout  << endl;
}

void show_int_tuple_list(list<tuple<int, int, int>> l)
{
    for (auto v : l)
        cout << "(" << get<0>(v) << ", "
             << get<1>(v) << ", "
             << get<2>(v) << ") ";
    cout  << endl;
}

int sq(int x)  // Diese Funktion kann in fmap_list<int, int> verwendet werden
{
    return x*x;
}

list<int> five(int x)  // Diese Funktion kann in bind<int, int> verwendet werden und ignoriert die Listenelemente x
{
    return return_list(5);
}

int main(void)
{
    list<int> myints{1, 2, 3};
    list<int> myotherints{7, 8, 9, 10};

    cout << "myints: ";
    show_list<int>(myints);
    cout << "myotherints: ";
    show_list<int>(myotherints);

    list<int> squares = fmap_list<int, int>(sq, myints); // myints quadrieren
    cout << "squares: ";
    show_list<int>(squares);

    list<int> result =
    bind_list<int, int>(myints, [myotherints](int x) { return
    bind_list<int, int>(myotherints, [x](int y) { return
                        return_list(x + 3*y); }); });
    // Hier werden aus verschiedenen int-Listen die Elemente miteinander verrechnet
    cout << "result = do\n\tx <- myints\n\ty <- myotherints\n\treturn (x + 3*y)\nresult: ";
    show_list<int>(result);
    list<tuple<int, int, int>> result2 =
    bind_list<int, tuple<int, int, int>>(myints, [myotherints](int x) { return
    bind_list<int, tuple<int, int, int>>(myotherints, [x](int y) { return
                                         return_list(tuple(x + 3*y, x, y)); }); });
    // Hier werden aus verschiedenen int-Listen die Elemente miteinander verrechnet und in eine Tupel-Liste gesteckt
    cout << "result2 = do\n\tx <- myints\n\ty <- myotherints\n\treturn (x + 3*y, x, y)\nresult2: ";
    show_int_tuple_list(result2);
    return 0;
}
Die Ausgabe ist:
myints: 1 2 3
myotherints: 7 8 9 10
squares: 1 4 9
result = do
	x <- myints
	y <- myotherints
	return (x + 3*y)
result: 22 25 28 31 23 26 29 32 24 27 30 33
result2 = do
	x <- myints
	y <- myotherints
	return (x + 3*y, x, y)
result2: (22, 1, 7) (25, 1, 8) (28, 1, 9) (31, 1, 10) (23, 2, 7) (26, 2, 8) (29, 2, 9) (32, 2, 10) (24, 3, 7) (27, 3, 8) (30, 3, 9) (33, 3, 10)
In result wird aus zwei int-Listen eine neue int-Liste berechnet und man muss dabei nur beschreiben, wie die Einzelelemente zu kombinieren sind. result2 ist ein Beispiel, wie aus int-Listen auch andere Listen (hier Tupel) berechenbar sind, wobei auch hier nur die Verarbeitung der Einzelelemente zu beschreiben ist. Alle eingegebenen Listen werden abgearbeitet und alle Elemente der entsprechenden Listen werden miteinander, ohne Bezug zur Listen-Struktur, kombiniert, wie man am Tupel-Beispiel nachvollziehen kann.
Die eigentümliche Formatierung des Codes dient zur Veranschaulichung: Die do-Notation in Haskell spart die bind-Aufrufe ein und gestattet es, die monadische Verkettung in einer imperativen Form zu schreiben.
Eine Monade beschreibt somit, wie man „in“ oder „unter“ einem Behälter/Container rechnet. Im Prinzip kann man für andere Container-Typen ähnlich vorgehen. Man muss nur Implementierungen für return, fmap und join vorgeben, welche die Monadengesetze erfüllen.
Listenmonade mit Hilfe einer Formalisierung der Kategorientheorie in Agda
[Bearbeiten | Quelltext bearbeiten]Im Folgenden wird die ("cons"-)Listenmonade mit all ihren Gesetzmäßigkeiten in Agda implementiert und ihre Funktionsweise im Programm demonstriert. Die Beweise werden ausgeschrieben und verweisen möglichst wenig auf die Agda-Standardbibliothek[4]. Folgende Importe werden benötigt: Die Levels der Typ-Universalhierarchie,
module ListMonad where
  open import Level renaming (zero to lzero)
die Konzepte aus der Kategorientheorie[5]: Kategorie (Category), Funktor zusammen mit einem Identitätsfunktor (Functor, idF), Monade (Monad) sowie die Kategorie Sets deren Objekte auf Level lzero "kleine" Typen sind.
  open import Categories.Category using (Category)
  open import Categories.Functor using (Functor) renaming (id to idF)
  open import Categories.Monad using (Monad)
  open import Categories.Category.Instance.Sets using (Sets)
Weiterhin werden die Identitätsfunktion idf und der Listentyp mit seinen Konstruktoren sowie map importiert. Zur Formulierung der Beweise braucht man die propositionale Äquivalenz _≡_ mitsamt Konstruktor refl sowie den zwei Funktionen cong und sym.
  open import Function renaming (id to idf)
  open import Data.List using (List ; [] ; _∷_ ; map)
  import Relation.Binary.PropositionalEquality as Eq
  open Eq using (_≡_ ; refl ; cong ; sym)
Zuerst definiert man den Listenfunktor, denn eine Monade braucht immer einen zugrundeliegenden Endofunktor. Da ein Funktor eine Quell- und eine Zielkategorie benötigt, die hier aber zusammenfallen, wird diese als allererstes definiert. Es handelt sich um die Kategorie der "kleinen" Typen:
  smallTypesCategory : Category (suc lzero) lzero lzero
  smallTypesCategory = Sets lzero
Die entsprechende typwertige Funktion ist List. Die Morphismenabbildung ist durch map gegeben. Sie macht aus einem Morphismus zwischen "kleinen" Typen einen Morphismus zwischen Listen von "kleinen" Typen.
  listFunctor : Functor smallTypesCategory smallTypesCategory
  listFunctor .Functor.F₀ = List
  -- Typ: Set → Set  (die Objekte von "smallTypesCategory")
  listFunctor .Functor.F₁ = map
  -- Typ (Haskell: (a -> b) -> [a] -> [b]): (A → B) → List A → List B
Ein Funktor muss zwei Gesetzmäßigkeiten erfüllen. Diese werden im vorliegenden Fall durch eine Fallunterscheidung zwischen der leeren Liste [] und der Liste mit mindestens einem Elemente ("cons"-Liste) x ∷ xs bewiesen.
  listFunctor .Functor.identity {X} = F-identity
    where
      F-identity : (xs : List X) → map idf xs ≡ xs
      F-identity []       = refl
      F-identity (x ∷ xs) = cong (x ∷_) (F-identity xs)
  listFunctor .Functor.homomorphism {X = X} {f = f} {g = g} = F-homomorphism
    where
      F-homomorphism : (xs : List X) → map (λ y → g (f y)) xs ≡ map g (map f xs)
      F-homomorphism []       = refl
      F-homomorphism (x ∷ xs) = cong (g (f x) ∷_) (F-homomorphism xs)
Die dritte Gesetzmäßigkeit ist technischer Natur und fordert, dass der Funktor mit der Äquivalenzrelation der Morphismen in beiden Kategorien verträglich ist. Da es sich hier um einen Funktor der Kategorie kleiner Typen in sich handelt, fragt man hier danach, ob, wenn zwei Funktionen (Morphismen) punktweise gleich sind, ihre Abbildungen unter dem Funktor auf die gleichen Listen angewendet auch gleich sind. Im Folgenden werden längere Gleichungsbeweise (engl. equational reasoning) mit begin eingeleitet und mit ∎, also dem Symbol für q.e.d., beendet. Dabei wird die linke Seite der Gleichung in die rechte umgeformt.
  listFunctor .Functor.F-resp-≈ {A} {B} {f} {g} = F-resp-≈
    where
      F-resp-≈ : ((x : A) → f x ≡ g x) → (xs : List A) → map f xs ≡ map g xs
      F-resp-≈ f≡g []       = refl
      F-resp-≈ f≡g (x ∷ xs) = begin
        map f (x ∷ xs) ≡⟨⟩  -- Def. map
        f x ∷ map f xs ≡⟨ cong (_∷ map f xs) (f≡g x) ⟩
        g x ∷ map f xs ≡⟨ cong (g x ∷_) (F-resp-≈ f≡g xs) ⟩
        g x ∷ map g xs ≡⟨⟩  -- Def. map
        map g (x ∷ xs)
        ∎
        where open Eq.≡-Reasoning
Damit ist bewiesen, dass List ein Funktor ist. Für die Behandlung von List als Monade braucht man als Kategorienkonzept natürliche Transformationen, NaturalTransformation, und aus den Hilfsfunktionen für Listen benötigt man concat, foldr sowie die (Infix-)Listenverkettung _++_.
  open import Categories.NaturalTransformation
  open import Data.List using (concat ; foldr ; _++_)
Die Monade wird ebenfalls über der Kategorie "kleiner" Typen definiert,
listMonad : Monad smallTypesCategory
der Funktor listFunctor wird als Endofunktor der Monade benutzt.
listMonad .Monad.F = listFunctor
Als natürliche Transformation return, hier η genannt, die aus einem "reinen" Wert einen monadischen macht, wird die einelementige Liste x ∷ [] herangezogen.
  -- return --
  listMonad .Monad.η .NaturalTransformation.η X x = x ∷ []
  -- Typ: (X : Set) → X → List X
Weiter sind jetzt die Beweise der Natürlichkeit zu führen, wobei sym-commute technisch bedingt redundant ist.
  listMonad .Monad.η .NaturalTransformation.commute f x = refl
  -- Typ: (f : X → Y) (x : X) → f x ∷ [] ≡ f x ∷ []
  listMonad .Monad.η .NaturalTransformation.sym-commute f x
    = sym (listMonad .Monad.η .NaturalTransformation.commute f x)
Die join-Funktion wird hier mit μ bezeichnet und entspricht der Funktion concat, die Listen abflacht.
  -- join --
  listMonad .Monad.μ .NaturalTransformation.η X = concat
  -- Typ: (X : Set) → List (List X) → List X
Der Beweis, dass die join-Funktion natürlich ist, ist etwas komplizierter. Hier ist es notwendig, dass man die Homomorphismuseigenschaft von map bzgl. der Listenverkettung _++_ nutzt (siehe letzter Beweisschritt und where-Klausel). Im Folgenden bietet es sich an, die Funktion foldr mit den Argumenten _++_ und [] als Einheit foldr _++_ [] zu betrachten.
  listMonad .Monad.μ .NaturalTransformation.commute {X} f = join-commute
    where
      join-commute : (xss : List (List X)) →
                     foldr _++_ [] (map (map f) xss) ≡ map f (foldr _++_ [] xss)
      join-commute []         = refl
      join-commute (xs ∷ xss) =
        begin
          foldr _++_ [] (map (map f) (xs ∷ xss))
            ≡⟨⟩  -- Def. foldr
          map f xs ++ foldr _++_ [] (map (map f) xss)
            ≡⟨ cong (map f xs ++_) (join-commute xss) ⟩
          map f xs ++ map f (foldr _++_ [] xss)
            ≡⟨ map-homomorphism xs (foldr _++_ [] xss) ⟩
          map f (xs ++ foldr _++_ [] xss)
            ≡⟨⟩  -- Def. foldr
          map f (foldr _++_ [] (xs ∷ xss))
          ∎
          where
            open Eq.≡-Reasoning
            map-homomorphism : (ys zs : List X) → map f ys ++ map f zs ≡ map f (ys ++ zs)
            map-homomorphism [] zs       = refl
            map-homomorphism (x ∷ ys) zs = cong (f x ∷_) (map-homomorphism ys zs)
sym-commute ist wieder eine technische Notwendigkeit und bis auf sym identisch mit join-commute.
  listMonad .Monad.μ .NaturalTransformation.sym-commute {X} f xss
    = sym (listMonad .Monad.μ .NaturalTransformation.commute {X} f xss)
Nun muss man noch die Monadengesetze beweisen. Davon ist das Assoziativgesetz das komplizierteste. Auch hier existiert aus technischen Gründen eine sym-assoc-Variante. Im Assoziativgesetz muss ausgenutzt werden, dass foldr für _++_ mit [] als Startelement auch ein Homomorphismus von _++_ ist. Dabei ist es notwendig, das Assoziativgesetz von _++_ zu benutzen.
  listMonad .Monad.assoc {X} = monad-assoc
    where
      monad-assoc : (xsss : List (List (List X))) →
                    foldr _++_ [] (map (foldr _++_ []) xsss) ≡
                    foldr _++_ [] (foldr _++_ [] xsss)
      monad-assoc []           = refl
      monad-assoc (xss ∷ xsss) = begin
        foldr _++_ [] (map (foldr _++_ []) (xss ∷ xsss))
          ≡⟨⟩  -- Def. foldr
        foldr _++_ [] xss ++ foldr _++_ [] (map (foldr _++_ []) xsss)
          ≡⟨ cong (foldr _++_ [] xss ++_) (monad-assoc xsss) ⟩
        foldr _++_ [] xss ++ foldr _++_ [] (foldr _++_ [] xsss)
          ≡⟨ sym (fold-++-[]-homomorphism xss (foldr _++_ [] xsss)) ⟩
        foldr _++_ [] (xss ++ foldr _++_ [] xsss)
          ≡⟨⟩  -- Def. foldr
        foldr _++_ [] (foldr _++_ [] (xss ∷ xsss))
        ∎
        where
          open Eq.≡-Reasoning
          ++-assoc : (xs ys zs : List X) → (xs ++ ys) ++ zs ≡ xs ++ (ys ++ zs)
          ++-assoc [] ys zs       = refl
          ++-assoc (x ∷ xs) ys zs = cong (x ∷_) (++-assoc xs ys zs)

          fold-++-[]-homomorphism : (xss yss : List (List X)) →
                                    foldr _++_ [] (xss ++ yss) ≡
                                    foldr _++_ [] xss ++ foldr _++_ [] yss
          fold-++-[]-homomorphism [] yss         = refl
          fold-++-[]-homomorphism (xs ∷ xss) yss = begin
            foldr _++_ [] (xs ∷ xss ++ yss)
              ≡⟨⟩  -- Def. foldr
            xs ++ foldr _++_ [] (xss ++ yss)
              ≡⟨ cong (xs ++_) (fold-++-[]-homomorphism xss yss) ⟩
            xs ++ foldr _++_ [] xss ++ foldr _++_ [] yss
              ≡⟨ sym (++-assoc xs (foldr _++_ [] xss) (foldr _++_ [] yss)) ⟩
            (xs ++ foldr _++_ [] xss) ++ foldr _++_ [] yss
              ≡⟨⟩  -- Def. foldr
            foldr _++_ [] (xs ∷ xss) ++ foldr _++_ [] yss
            ∎

  listMonad .Monad.sym-assoc {X} xsss = sym (listMonad .Monad.assoc {X} xsss)
Die links- und rechtsseitigen Identitäten der Monade sind wiederum so einfach, dass sie keines Gleichungsbeweises bedürfen und als reine Fallunterscheidung behandelt werden können.
  listMonad .Monad.identityˡ {X} = monad-identityˡ
    where
      monad-identityˡ : (xs : List X) → foldr _++_ [] (map (λ y → y ∷ []) xs) ≡ xs
      monad-identityˡ []       = refl
      monad-identityˡ (x ∷ xs) = cong (x ∷_) (monad-identityˡ xs)
  listMonad .Monad.identityʳ {X} = monad-identityʳ
    where
      monad-identityʳ : (xs : List X) → xs ++ [] ≡ xs
      monad-identityʳ []       = refl
      monad-identityʳ (x ∷ xs) = cong (x ∷_) (monad-identityʳ xs)
Die so definierte und bewiesene Listenmonade kann nun im Programm eingesetzt werden. Dazu wird hier ein eigenes Modul eröffnet und die natürlichen Zahlen zusammen mit Addition und Multiplikation eingebunden. Zusätzlich wird die Funktionsverkettung, _∘′_, importiert.
  module ListMonadExample where
    open import Data.Nat using (ℕ ; _+_ ; _*_)
    open import Function using (_∘′_)
Zur Verwendung der sog. do-Notation in Agda braucht man den bind-Operator _>>=_.
    -- ma >>= f = (join ∘ (fmap f)) ma
    _>>=_ : {A B : Set} → List A → (A → List B) → List B
    _>>=_ {A} {B} ma f
      = (listMonad .Monad.μ .NaturalTransformation.η B ∘′ listMonad .Monad.F .Functor.F₁ f) ma
Weiterhin bietet es sich an, return explizit zu definieren:
    return : {A : Set} → A → List A
    return {A} = listMonad .Monad.η .NaturalTransformation.η A
Nun kann man eine Liste natürlicher Zahlen mit Hilfe zweier anderer Listen und einer Rechenoperation erzeugen.
    z₁ : List ℕ
    z₁ = do
      x ← 1 ∷ 2 ∷ 3 ∷ []
      y ← 7 ∷ 8 ∷ 9 ∷ 10 ∷ []
      return (x + 3 * y)

    z₂ : List ℕ
    z₂ = do
      x ← 5 ∷ 6 ∷ []
      y ← 3 ∷ 2 ∷ 1 ∷ []
      (x + 3 * y) ∷ (2 * x + y) ∷ []
Ein Unit-Test zeigt, dass die Listen mit den erwarteten Ergebnissen übereinstimmen.
    _ : z₁ ≡ 22 ∷ 25 ∷ 28 ∷ 31 ∷ 23 ∷ 26 ∷ 29 ∷ 32 ∷ 24 ∷ 27 ∷ 30 ∷ 33 ∷ []
    _ = refl

    _ : z₂ ≡ 14 ∷ 13 ∷ 11 ∷ 12 ∷ 8 ∷ 11 ∷ 15 ∷ 15 ∷ 12 ∷ 14 ∷ 9 ∷ 13 ∷ []
    _ = refl
Die Formalisierung der Kategorientheorie in Agda hilft dabei, eigene Monaden zu definieren, zu beweisen, dass es welche sind sowie, nach Definition eines bind-Operators, im Programm zu nutzen.
Die triviale (Identitäts-)Monade für mathematische Berechnungen
[Bearbeiten | Quelltext bearbeiten]Mathematische Berechnungen mit einem „reinen“ Ergebnis können auch in eine Monade eingebettet werden. Hier ist der „höhere“ Typ der abstrakte Typ der Berechnung selbst (Man spricht von der Identitäts-Monade weil man keinen Behälter oder Container für die Werte braucht). Man macht also nicht aus einem abstrakten Typ a eine Liste von a oder ein Maybe a, sondern man lässt das a wie es ist. Damit besitzen die Monadenoperationen folgende Funktionstypen: return : a -> a, fmap : (a -> b) -> a -> b und join : a -> a. Das heißtreturn x = x (Identitätsfunktion), join x = x (auch Identitätsfunktion) und fmap f x = f x (Funktionsanwendung). Die bind-Funktion verkettet dann einfach mathematische Funktionen miteinander (Hintereinanderausführung). In C++ könnte die Implementierung so aussehen:
template <typename T> T return_id(T t)
{
    return t;
}

template <typename T> T join_id(T t)
{
    return t;
}

template <typename A, typename B> B fmap_id(function<B(A)> f, A a)
{
    return f(a);
}

template <typename A, typename B> B bind_id(A ma, function<B(A)> f)
{
    return join_id(fmap_id(f, ma));  // beachte, dass bind_id dieselbe Struktur wie bind_list hat
}
Die Anwendung erfolgt genau wie bei der Listenmonade:
// ... main ...
    int mysingleint = 4;
    int myothersingleint = 5;
    cout << "mysingleint: " << mysingleint << " myothersingleint: " << myothersingleint << endl;
    int result_id = bind_id<int, int>(
        mysingleint,
        [myothersingleint](int x) { return bind_id<int, int>(
                                     myothersingleint,
                                    [x](int y) { return return_id(x + 3*y); });
                                    });
    cout << "result_id = do\n\tx <- mysingleint\n\ty <- myothersingleint\n\treturn (x + 3*y)\nresult_id: ";
    cout << result_id << endl;
Auch hier hat man wieder die gleiche Struktur, nur dass man diesmal auf einzelnen Zahlen operiert. Die Ausgabe ist:
mysingleint: 4 myothersingleint: 5
result_id = do
	x <- mysingleint
	y <- myothersingleint
	return (x + 3*y)
result_id: 19
Demzufolge kann man auch bestimmte Operationen erst einmal auf einfachen Daten testen und hinterher einfach die zugrunde liegende Monade austauschen.
Vektoren und lineare Abbildungen
[Bearbeiten | Quelltext bearbeiten]Der Typkonstruktor bildet hier einen Typ auf einen Vektorraum ab, bei dem als (Namensgeber für eine) Basis dient, und dessen Elemente beispielsweise als Funktionen modelliert werden. Die Bindeoperation hat den Typ . Durch Vertauschen der Argumente erhält man den Typ , an dem man die Semantik erkennen kann: die gegebene Funktion, die auf den Basiselementen definiert ist, wird zu einer vollen linearen Abbildung erweitert. Die Einheitsfunktion bildet das Basiselement (welches in dieser Modellierung noch kein „richtiger“ Vektor ist) auf den entsprechenden Basisvektor ab.


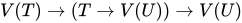

Zustände
[Bearbeiten | Quelltext bearbeiten]Wenn man in einer rein funktionalen Programmiersprache einen Zustand (engl. state) im Programm, z. B. veränderbare (engl. mutable) globale Variablen, simulieren will, dann macht man das in der Regel auf folgende Weise:
def countAppendString(n: int, s1: str, s2: str) -> Tuple[int, str]:
    return (n + 1, s1 + s2)
Hier soll der erste Parameter n in der Aufrufliste der alte Zustand und n + 1 im zurückgegebenen Tupel der neue Zustand sein. Um alles, was mit dem Zustand zu tun hat, von den anderen Parametern zu trennen, kann man den Zustandsparameter als letzten in der Parameterliste verwenden und beide Teile separieren. Damit ergibt sich die äquivalente Formulierung
def countAppendString2(s1: str, s2: str) -> Callable[[int], Tuple[int, str]]:
    def _f(n: int) -> Tuple[int, str]:
        return (n + 1, s1 + s2)
    return _f
Hier werden die Parameter s1 und s2, die nichts mit dem zu verändernden Zustand n zu tun haben, an eine Funktion übergeben, die eine Funktion mit Parameter n zurückgibt, die ihrerseits den Tupel mit neuem Zustand n + 1 und Ergebnis s1 + s2 zurückgibt. Der Rückgabetyp von countAppendString2 gibt schon einen Hinweis auf die Typstruktur eines Zustands: Die beiden ints im Callable repräsentieren den Zustand, der mitgeführt und ggf. verändert wird, und der str den Rückgabewert der Funktion.
Das Grundprinzip ist, dass man als Parameter der Funktion den alten Zustand anhängt und den neuen mit dem Rückgabewert zusammen zurückgibt, da man keine Werte verändern kann.
In Agda (und auch Haskell) würde man die Funktion oben wie folgt schreiben:
open import Data.Nat using (ℕ ; _+_)
open import Data.String using (String) renaming (_++_ to _++ₛ_)
open import Data.Unit using (⊤ ; tt)

Zähler : Set
Zähler = ℕ

countStringAppend : String → String → Zähler → Zähler × String
countStringAppend s₁ s₂ n = (n + 1 , s₁ ++ₛ s₂)
Zur besseren Zuordnung wurde ein neuer Typ Zähler eingeführt. Man sieht, dass Zähler als letztes Argument in der Funktion auftaucht und als erster Eintrag im Ergebistupel. In Haskell und Agda kann man dieses Muster in einen neuen Typen verpacken. Der Parameter S ist der Typ des Zustands, A ist der Typ des Rückgabewertes:
State : Set → Set → Set
State S A = S → S × A
Damit kann man die Funktion und ihre Typsignatur wie folgt umschreiben:
countStringAppend′ : String → String → State Zähler String
countStringAppend′ s₁ s₂ n = (n + 1 , s₁ ++ₛ s₂)
State entspricht im Wesentlichen dem Callable-Typ in der Pythondarstellung weiter oben.
Nun braucht man Funktionen, die den Zustand manipulieren können. Dies ist zum einen eine Funktion, die den Zustand auf einen neuen Wert setzt, und zum anderen eine, die ihn ausliest:
putState : {S : Set} → S → State S ⊤  -- S → S → S × ⊤
putState s = λ _ → s , tt

getState : {S : Set} → State S S  -- S → S × S
getState s = s , s
Wichtig ist, dass im Folgenden alle Funktionen in irgendeiner Form einen Typ State zurückgeben. Das bietet sich selbst dann an, wenn man nicht über Monaden spricht.
getState dupliziert den Zustand in den Ergebnistyp, weil man später nur mit dem Ergebnistyp arbeiten kann. Der Zustand selbst ist "wegabstrahiert". Das bedeutet, er ist in der verwendeten Abstraktion (der Monade) nicht mehr explizit zugreifbar, da State S (ohne A) dem M in der Monadendefinition entspricht. Man spricht bei State also von einer ganzen Familie von Monaden, für jeden Zustandstyp S eine.
putState ignoriert den aktuellen Zustand (_ als Argument in der anonymen Funktion) und setzt einfach einen neuen mit Rückgabewert tt aus dem Einheitstyp ⊤.
Dies ist schon fast alles, was nötig ist. Das einzige, was noch fehlt, ist die Möglichkeit mehrere zustandsverändernde Aktionen zu kombinieren, hier sind Monaden mit ihrer bind- und return-Operation das Werkzeug der Wahl.
_>>=_ : {S A B : Set} → State S A → (A → State S B) → State S B
(zustand₁ >>= f) s with (zustand₁ s)
... | zwischenzustand , rückgabe₁ = zustand₂ zwischenzustand
  where
    zustand₂ = f rückgabe₁
bind (hier _>>=_) nimmt einen Zustand mit Rückgabetyp A und überführt ihn mit einer Funktion, die aus einem reinen A einen Zustand mit Rückgabetyp B macht, in einen Zustand mit Rückgabetyp B. Dabei wird der erste Zustand in seine Bestandteile zwischenzustand und rückgabe₁ zerlegt und nach Umwandlung von rückgabe₁ mit Hilfe von f in zustand₂ als zustand₂ mit Parameter zwischenzustand zurückgegeben. Beachte, dass man über f keine weitere Information hat als die Typsignatur, da es vom Aufrufer bereitgestellt wird.
return : {A S : Set} → A → State S A
return a = λ s → s , a
return macht aus einem reinen Typ einen monadischen. Hier wird im Zustand einfach der reine Wert, der als Parameter eingeht, als Ergebnis zurückgegeben.
In Haskell bietet es sich an, diese beiden Funktionen in einer Typklasseninstanz zusammenzufassen. In Agda sollten sie als Felder im record zur Monade auftauchen.
Mit diesen Funktionen und der do-Notation (die die monadischen Operationen versteckt) lässt sich das Beispiel dann folgendermaßen formulieren:
countStringAppend′′ : String → String → State Zähler String
countStringAppend′′ s₁ s₂ = do
  zähler ← getState
  putState (zähler + 1)
  return (s₁ ++ₛ s₂)

-- Anwendung:
z : Zähler × String
z = countStringAppend′′ "hallo" "welt" 10 -- (11 , "hallowelt")
zähler erscheint hier wie eine globale Variable, die man verändern kann und die in der Parameterliste nicht auftaucht. Am Schluss hat man einen Aufruf von return, der signalisiert, dass das Ergebnis der Funktion zurückgegeben wird. Man vergleiche das mit einer Pythonfunktion
def countAppendStringGlobal(s1: str, s2: str) -> str:
    global zähler
    zähler = zähler + 1
    return (s1 + s2)
Die Variante ohne do-Notation (und Infix-bind) sieht wie folgt aus:
bind = _>>=_
countStringAppend′′′ : String → String → State Zähler String
countStringAppend′′′ s₁ s₂ = bind (λ s → s , s) {-getState-}
                                  (λ zähler → bind (λ _ → zähler + 1 , tt) {-putState-}
                                                   (λ _ → (λ zähler′ → zähler′ , s₁ ++ₛ s₂) {-return-}))
Man sieht, dass diese Variante relativ komplex ist. Daher erleichtert einem die do-Notation den Umgang mit allgemeineren Monaden sehr.
Andere Sprachen
[Bearbeiten | Quelltext bearbeiten]LINQ-Abfrageausdrücke in C# sind direkt inspiriert von Haskells do-Notation.[6] Ein Analogon zur Typklasse Monad ist in C# jedoch nicht ausdrückbar; der Compiler übersetzt LINQ-Abfrage-Ausdrücke blind in Aufrufe von Methoden mit festgelegten Namen. Diese sind Select und SelectMany. Auch benutzerdefinierte Klassen können also mittels LINQ-Abfrageausdrücken angesprochen werden, wenn diese Methoden mit entsprechenden Namen zur Verfügung stellen.
Dieselbe Strategie verfolgt Scala im Fall von for-Comprehensions.[7] Die Methoden heißen da map und flatMap.
In der Standardbibliothek von Java 8 sind mindestens zwei Monaden vorhanden, die derselben Namenskonvention gehorchen: die Schnittstellen Optional und Stream definieren Methoden namens map, flatMap und of.
Weblinks
[Bearbeiten | Quelltext bearbeiten]- Papers von Philip Wadler
- You Could Have Invented Monads! (And Maybe You Already Have.)
- What a Monad is not
- Brent Yorgey: Typeclassopedia (PDF; 722 kB) in: The Monad.Reader Issue 13
Monaden in anderen Programmiersprachen
[Bearbeiten | Quelltext bearbeiten]- Monads in Groovy[8]
- Monads in Python[9]
- Monads in Scala[10]
- Monads in Clojure[11]
- Monads in JavaScript[12]
Einzelnachweise
[Bearbeiten | Quelltext bearbeiten]- ↑ Simon L. Peyton Jones, Philip Wadler: Imperative Functional Programming. Conference record of the Twentieth Annual ACM SIGPLAN-SIGACT Symposium on Principles of Programming Languages, Charleston SC 1993
- ↑ Andrej Bauer: LOGRAC ISRM 2022 Records as structures. ab etwa 1:43:00 h.
- ↑ downloads.haskell.org
- ↑ https://agda.github.io/agda-stdlib/ Agda Standardbibliothek (abgerufen am 9. August 2026)
- ↑ https://agda.github.io/agda-categories/ Agda Categories-Bibliothek (abgerufen am 10. August 2026)
- ↑ Erik Meijer: The World According to LINQ. (acm.org).
- ↑ scala-lang.org
- ↑ Monads in Groovy ( vom 5. August 2021 im Internet Archive)
- ↑ Monads in Python
- ↑ Monads in Scala ( vom 7. Juni 2011 im Internet Archive)
- ↑ Monads in Clojure
- ↑ Monads in JavaScript ( vom 22. Dezember 2010 im Internet Archive)
- ↑ Wes Dyer: The Marvels of Monads. In: Yet Another Language Geek. MSDN Blogs, Microsoft, 10. Januar 2008, abgerufen am 21. März 2013.
- ↑ Mike Hadlow: Monads in C#. In: Code Rant. 9. Januar 2011, abgerufen am 21. März 2013.
- ↑ Muraad Nofal: Monads-CSharp. In: GitHub. 10. März 2014, abgerufen am 21. März 2013.